
银行拥有海量客户数据,包括交易历史、产品持有记录、人口统计画像和行为模式。如何将这些数据转化为可操作的个性化产品推荐,一直是核心挑战。传统基于规则的系统或协同过滤方法,往往难以捕捉客户产品采纳过程中的复杂时间模式。本文介绍了一种基于 **Amazon SageMaker AI** 和 **PyTorch** 的“下一最佳产品”(NBP)推荐系统架构与设计决策,重点阐释多塔神经网络的设计逻辑、如何通过学习注意力机制实现客户级别的可解释性,以及 AWS 服务如何协同将方案从研究推向生产。 ## 架构核心:多塔神经网络 推荐系统的核心是一个 **多塔神经网络**。每个“塔”处理一类异构输入:客户人口统计特征、历史交易序列、现有产品持有情况等。不同塔使用不同层数和激活函数,以适配各自数据特性。例如,交易序列塔采用 **GRU** 或 **Transformer** 编码时序依赖,而静态特征塔则使用全连接层。各塔输出通过拼接或加权融合,最终预测客户购买每种产品的概率。这种设计让模型既能处理稀疏类别特征,也能学习连续数值的深层模式。 ## 可解释性的关键:学习注意力机制 银行业对模型可解释性有严格监管要求。为此,系统在模型中引入 **学习注意力层**。注意力机制为每个输入特征(如某笔交易、某个产品持有)分配权重,从而指明哪些因素对推荐结果影响最大。例如,当模型推荐“住房贷款”时,注意力权重可能显示“近期大额消费记录”和“已有按揭账户”是关键驱动因素。这种基于实例的解释方式,既满足合规需求,也帮助业务人员理解并信任模型。 ## AWS 服务集成与生产化路径 从数据准备到模型部署,方案充分利用了 AWS 托管服务: - **AWS Glue**:清洗和特征工程,将原始交易日志转为结构化序列。 - **Amazon S3**:存储训练数据、模型工件和特征存储。 - **Amazon SageMaker AI**:提供端到端的模型训练、调优、部署和监控。训练使用 PyTorch 框架,支持分布式训练以加速大规模数据迭代。 - **Amazon CloudWatch**:监控推理端点性能,确保推荐延迟满足实时场景。 生产部署时,SageMaker 端点提供实时推理,同时可配置 **批处理转换** 用于离线推荐。模型版本管理、A/B 测试均可通过 SageMaker 实验和管道功能实现。 ## 适用性与价值 虽然本方案专为银行设计,但其架构模式可推广至保险、电信等拥有多源异构客户数据的行业。**可解释的推荐** 不仅满足监管,还能增强客户信任,提升交叉销售和客户留存。对于希望将深度学习推荐系统落地,并兼顾准确性与透明度的团队,这是一个值得参考的蓝本。
OpenAI 最新一代 GPT-5.6 系列模型——**Sol**、**Terra** 和 **Luna**——现已正式在 Amazon Bedrock 上提供。这三个模型分别面向自主编码与长链条推理、日常生产负载以及高吞吐低延迟推理场景,通过统一的 Responses API 在 bedrock-mantle 端点访问,支持文本和图像输入、272K token 上下文窗口,并可调节推理强度。定价与 OpenAI 官方一致,且使用量计入 AWS 承诺消费。本文从模型选择、首次推理、提示缓存、Codex 集成到配额规划,提供完整入门指南。 ## 模型概览:Sol、Terra、Luna 各司其职 GPT-5.6 系列采用新的命名体系:数字代表代际,名称(Sol、Terra、Luna)代表能力等级。三款模型在 Amazon Bedrock 上的关键规格如下: | 模型 | 模型 ID | 最佳适用场景 | 支持区域 | |------|---------|--------------|----------| | **Sol** | `openai.gpt-5.6-sol` | 自主编码、安全研究、科学分析、深度多步推理 | 美东(弗吉尼亚、俄亥俄) | | **Terra** | `openai.gpt-5.6-terra` | 平衡推理能力与成本的通用生产负载 | 美东(弗吉尼亚、俄亥俄)、美西(俄勒冈) | | **Luna** | `openai.gpt-5.6-luna` | 分类、摘要、路由等高吞吐、低延迟场景 | 美东(弗吉尼亚、俄亥俄)、美西(俄勒冈) | 三者均支持 **文本和图像输入**、**文本输出**,上下文窗口达 **272K token**,并可通过 `none`、`low`、`medium`、`high`、`xhigh`、`max` 参数调节推理努力程度。这意味着你可以在不修改 API 集成的前提下,根据任务复杂度切换模型。 ## 快速开始:通过 Responses API 运行推理 所有模型通过 OpenAI 的 **Responses API** 在 `bedrock-mantle` 端点访问。以下是一个调用 Sol 模型进行代码生成的 Python 示例(使用 boto3 和 Amazon Bedrock 的 Converse API): ```python import boto3 client = boto3.client("bedrock-runtime") response = client.converse( modelId="openai.gpt-5.6-sol", messages=[ {"role": "user", "content": [{"text": "Write a Python function to merge two sorted lists"}]} ], inferenceConfig={ "maxTokens": 4096, "temperature": 0.7 } ) print(response["output"]["message"]["content"][0]["text"]) ``` 与标准 Bedrock Converse API 一致,但需注意模型 ID 前缀为 `openai.gpt-5.6-`。 ## 降本技巧:提示缓存与缓存命中度量 **提示缓存**可显著降低重复请求的成本。当请求的提示前缀与缓存内容匹配时,系统自动返回缓存的中间状态,并只对未缓存部分计费。启用方式:在 API 请求中设置 `cache_config` 参数(如 `{"type": "prompt"}`),并确保提示内容可复用。 可通过响应中的 `usage.cached_tokens` 字段查看缓存命中情况。例如: ```json { "usage": { "input_tokens": 5000, "cached_tokens": 3000, "output_tokens": 200 } } ``` 表示 5000 个输入 token 中有 3000 个命中缓存,仅对剩余的 2000 个和输出 token 计费。 ## 集成 OpenAI Codex 编码代理 OpenAI Codex 编码代理可与 Sol 模型结合,实现自主代码编写与调试。集成步骤: 1. 在 Bedrock 中创建一个 **代理**,选择 Sol 作为基础模型。 2. 为代理配置 **代码解释器** 工具(需开启沙箱执行环境)。 3. 通过 API 或控制台向代理下达编码任务,如“编写一个 REST API 端点,使用 FastAPI”。 代理会自动调用 Sol 生成代码、执行并返回结果。注意:Codex 代理需要 AWS 账户具备 Bedrock 代理和 Lambda 执行权限。 ## 配额与扩展规划 每个 AWS 区域对 GPT-5.6 模型有初始配额限制,可通过 **Service Quotas** 控制台申请提升。关键配额包括: - **每分钟请求数(RPM)**:默认 100 - **每分钟 token 数(TPM)**:默认 100,000 - **并发推理数**:默认 5 建议根据生产负载预估,提前申请配额提升。对于高吞吐场景,可考虑使用 **Luna** 模型并结合 **提示缓存** 和 **批处理** 来优化。 ## 安全与隐私 **你的提示和输出不会用于训练任何模型**,也不会与模型提供商共享。所有数据在 AWS 区域内部处理,符合企业级安全与合规要求。 现在,你就可以在 Amazon Bedrock 控制台中启用 GPT-5.6 模型,开始探索自主编码、高效推理和生产级 AI 应用的新可能。
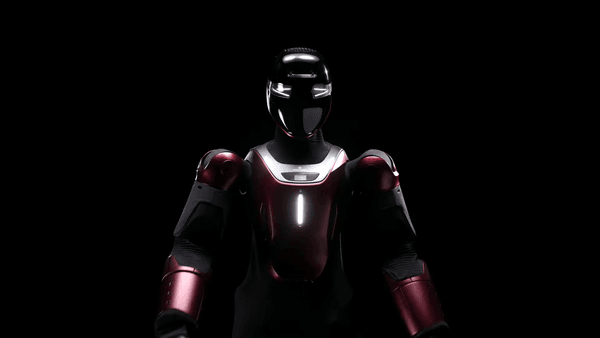
本周的机器人视频精选如约而至,其中最引人注目的是一台来自意大利的人形机器人——**Generative Bionics**。这台机器人不仅外观精致,更在运动能力和拟人化设计上展现出独特魅力,堪称“机器人界的意大利美学”。 ## 意大利人形机器人:当设计遇上工程 在机器人领域,意大利设计向来以优雅和艺术感著称。Generative Bionics 的这款人形机器人延续了这一传统,其流畅的线条和仿生关节结构让人联想到文艺复兴时期的雕塑。但它的内核却非常现代:搭载先进的运动控制算法,能够实现平稳行走、抓取物体甚至做出手势。视频中,机器人在实验室环境中完成了一系列动作,包括上下楼梯和搬运轻量物品,展示了其在复杂地形中的适应能力。 ## 本周其他亮点 除了这位“意大利明星”,本周视频精选还涵盖了多个领域的创新: - **波士顿动力**的 Spot 机器狗在建筑工地上进行自主巡检,利用激光雷达实时建模。 - **特斯拉 Optimus** 原型机展示了新的手指关节设计,能够更精细地操作工具。 - **软银 Robotics** 的 Pepper 机器人被用于日本养老院,通过语音交互帮助老人进行康复训练。 这些视频共同勾勒出机器人技术从实验室走向实际应用的清晰轨迹。 ## 行业观察:人形机器人热潮再起 近期,人形机器人领域迎来新一轮爆发。继特斯拉、Figure AI 等公司推出原型后,意大利团队的加入进一步丰富了竞争格局。值得注意的是,Generative Bionics 强调其机器人采用**模块化设计**,这意味着未来可能根据任务需求快速更换手臂或腿部组件,降低维护成本。这种设计思路与工业4.0的柔性制造理念不谋而合。 不过,距离真正意义上的“通用人形机器人”仍有距离。当前多数产品仍处于原型验证阶段,成本高昂且续航有限。但正如 IEEE Spectrum 的编辑所指出的:“每一次优雅的动作背后,都是成千上万次算法迭代。” ## 小结 本周视频再次证明:机器人不再只是冰冷机械,而是融合了美学、智能与实用性的艺术品。从意大利的优雅人形到日本的暖心陪护,技术进步正让科幻场景逐渐照进现实。下一周,又会有哪些惊喜?让我们拭目以待。
Bluesky 近日宣布,其 AI 助手 **Attie** 已从单纯的问答功能扩展为一款面向开放社交网络的研究工具。用户现在不仅可以向 Attie 提问,还能查询 Bluesky 以及基于 **AT 协议** 的其他应用上的新闻、趋势和对话内容。 ## 从助手到研究平台 Attie 最初作为一款实验性 AI 助手上线,旨在帮助用户快速获取信息。如今,它的定位发生了重要转变:不再局限于一对一问答,而是成为一个能够分析整个社交图谱和内容流的 **研究型工具**。这意味着用户可以通过自然语言提问,获取关于特定话题的讨论热度、意见分布、以及跨平台的趋势洞察。 ## 开放生态的优势 Bluesky 所采用的 **AT 协议** 是其去中心化社交网络的核心。与传统的封闭平台不同,AT 协议允许不同应用之间共享数据和交互。Attie 此次升级正是利用了这种开放性——它能够访问所有基于该协议构建的应用内容,而不仅仅是 Bluesky 自身。这为研究社交网络动态提供了前所未有的广度。 ## 使用场景与价值 对于记者、研究人员和普通用户而言,Attie 的新功能降低了获取社交洞察的门槛。例如,用户可以直接询问:“过去一周 Bluesky 上关于 AI 监管的讨论主要有哪些观点?”Attie 会综合多个 AT 协议应用的数据,生成一份简洁的总结。这种能力在传统社交平台上通常需要付费工具或复杂的数据抓取才能实现。 ## 未来展望 Bluesky 表示,Attie 将继续迭代,未来可能加入更多分析维度,如情感分析、网络影响者识别等。随着 AT 协议生态的扩大,Attie 有望成为研究去中心化社交网络的重要入口。不过,目前该工具仍处于早期阶段,其准确性和覆盖范围有待用户实际测试验证。 总的来说,Attie 的转型反映了 Bluesky 对开放数据价值的重视,也为社交网络分析领域带来了新的可能性。
以 AI 图像和视频生成工具闻名的 Midjourney,近日被曝收购了拥有约 430 万月活用户的社交星座应用 **Co-Star**。据 Bloomberg 报道,交易细节未公开,但 Co-Star 的约 24 人团队已整体加入 Midjourney。这并非 Midjourney 首次跨界——此前该公司已尝试拓展医疗和健康水疗业务。Co-Star 结合 AI 与人工方式为用户提供星座命盘、兼容性分析及运势建议,其团队在消费级应用开发上的经验,可能帮助 Midjourney 推出期待已久的独立 App。 ### 收购背后的逻辑:数据、用户与场景延伸 Co-Star 的吸引力在于其**社交属性**:用户不仅可查看个人星盘,还能与朋友分享并进行配对分析。对于 Midjourney 而言,这带来了两个关键价值: 1. **用户规模与粘性**:430 万月活用户意味着一个活跃的社交关系链,Midjourney 可借此测试其 AI 技术在非创意领域(如个性化内容生成)的应用。 2. **消费级产品经验**:Co-Star 团队此前成功打造了广受欢迎的移动应用,而 Midjourney 至今仍以 Discord 机器人形态存在,缺乏独立 App。此次收购被普遍视为 Midjourney 补齐产品短板、走向更广泛用户群体的信号。 ### AI+星座:个性化内容生成的新试验田 Co-Star 本身已在使用 AI 撰写运势和关系建议,这与 Midjourney 的核心能力(生成式 AI)高度契合。未来,Midjourney 可以将其图像和视频生成能力与 Co-Star 的个性化数据结合,例如为用户生成专属的星座插画或动画运势。这种“AI+玄学”的组合在年轻用户中具有天然吸引力,也为 Midjourney 提供了跳出创意工具赛道、探索**生活服务类 AI** 的切入点。 ### 从 Discord 到独立应用:Midjourney 的产品化之路 长期以来,Midjourney 一直依赖 Discord 作为交互界面,这限制了其用户增长和商业化潜力。Co-Star 团队的加入,可能加速 Midjourney 独立应用的开发。事实上,Midjourney 已公开表示希望推出更直观的移动端体验。收购一家成熟的应用团队,比从零组建更高效,也降低了试错成本。 ### 行业视角:AI 公司跨界收购成趋势 Midjourney 的收购并非孤例。AI 公司正通过收购来获取垂直领域的数据、用户和团队,以加速产品落地。类似案例包括 Anthropic 收购音频 AI 公司、Google 收购 DeepMind 等。对于 Midjourney 而言,Co-Star 不仅是用户入口,更是一个**数据富矿**——用户的星座偏好、社交互动记录,都能为训练更个性化的 AI 模型提供素材。 ### 挑战与不确定性 不过,这场收购也存在隐忧:星座应用的受众与 Midjourney 现有用户的重合度有多高?Co-Star 的 AI 能力与 Midjourney 的核心技术如何整合?更重要的是,Midjourney 能否在保持创意工具优势的同时,成功驾驭社交和健康等新领域?这些问题仍有待观察。 ### 小结 Midjourney 收购 Co-Star 是一次典型的“能力+场景”互补交易。前者获得消费级产品基因和社交数据,后者获得 AI 技术和资源支持。无论最终能否催生出独立 App,这一动作都表明 Midjourney 正从“工具型 AI”向“平台型 AI”演进。在 AI 行业竞争日趋激烈的当下,跨界整合或许正是突围的关键。
The AI “startups” worth billions of dollars are raising alarm bells about Chinese AI. The smaller players have a totally different take.
本周四,特朗普政府公布了首批“创世纪任务”资助计划,将**50亿美元**投向数百个AI驱动的科学项目。白宫称这一计划的“紧迫性和雄心堪比曼哈顿计划”。与此同时,总统科学顾问迈克尔·克拉齐奥斯在国会宣扬“美国科学的新黄金时代”,强调优先发展人工智能、机器人和核能,弱化生命科学。 这两项宣布清晰勾勒出特朗普重塑美国科学的蓝图。这是对科研体系更广泛战争的最新战线——此前已压制“觉醒”或DEI项目,以意识形态理由威胁大学和研究者的资金,限制国际学生与学者流入,并将联邦资金控制权空前地交给政治任命官员。 结果是长期建立的规范和制度正被系统性瓦解。这些制度虽有缺陷,但曾助美国成为世界科学超级大国。研究人员指出,这一愿景考虑不周且自相矛盾,与其说是科学复兴的蓝图,不如说是政治化的权力夺权,从根本上误解了科学如何运作。它将公共研究视为硅谷初创公司而非公共产品,偏爱可衡量的回报和速度,而非缓慢、不确定且不可预测的工作——而后者恰恰孕育了历史上最具变革性的发现。 “技术兄弟化”一词精准概括了这一趋势:科技高管和投资人背景的官员主导政策,强调快速落地和商业价值,忽视基础科学的长期积累。批评者警告,这可能导致美国科研生态失衡,失去在基础研究领域的领先优势。
The autonomous business of the future is being built. Certain skills are in high demand - and can help you stand out.
In a battle of the top Android watches, one does it a little better.
Chinese AI lab Moonshot’s open model Kimi went viral this week for reasons that had less to do with the model itself and more to do with how the U.S. AI industry reacted to it. Meanwhile, an unreleased OpenAI model wandered outside its test environment and ended up connected to a real security breach at Hugging Face — a reminder […]
Dell's 14S pairs a sleek design with excellent battery life, making it one of the best midrange PC I've tested in 2026.
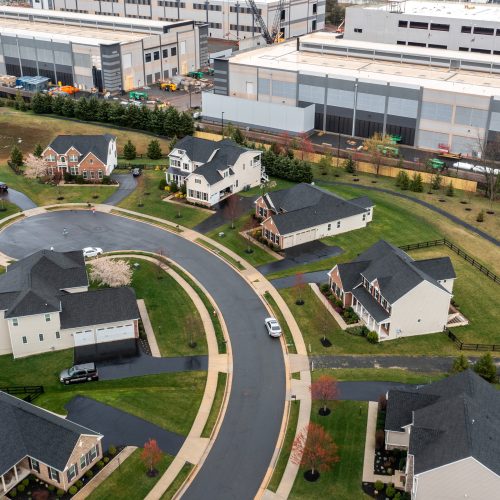
### 快讯:AI公司扩张数据中心,环保法规或迎重大调整 随着人工智能(AI)行业对算力的需求呈指数级增长,科技巨头们正竞相建设大规模数据中心。然而,这些项目在选址和建设过程中常常引发周边社区的担忧,涉及能源消耗、水资源使用、噪音污染以及环境影响等问题。据最新消息,特朗普政府领导下的美国环境保护署(EPA)可能推出新规,削弱地方政府和社区居民在数据中心选址过程中的发言权。 #### 新规核心:州政府拥有最终决定权 根据拟议中的规则,数据中心建设的审批权将更多集中在州一级政府,而非地方社区。这意味着,即使当地居民对项目存在强烈反对意见,只要州政府批准,项目仍可推进。EPA此举旨在简化审批流程,加速数据中心建设,以满足AI公司对计算资源的迫切需求。支持者认为,这有助于提升美国在AI领域的竞争力,避免因繁琐的审批程序延误关键基础设施的部署。 #### 争议焦点:环境正义与公众参与 然而,批评者指出,这一调整可能牺牲环境正义和公众参与权。数据中心通常需要消耗大量电力和水资源,其运营产生的碳排放和热污染对周边生态系统构成潜在威胁。过去,社区居民可以通过公开听证会、环境影响评估等渠道表达关切,甚至影响项目走向。新规若实施,这些渠道可能被大幅压缩,弱势群体和少数族裔社区可能首当其冲。 #### 行业背景:AI算力需求激增 AI模型的训练和推理需要庞大的计算集群,例如OpenAI的GPT系列、Google的Gemini等。据估算,一个大型AI数据中心的电力消耗可媲美中等城市。目前,美国科技公司如微软、亚马逊、谷歌正计划投资数十亿美元新建数据中心,但选址纠纷频发。例如,亚利桑那州、俄勒冈州等地曾发生居民抗议活动,反对数据中心占用宝贵的水资源和电力。 #### 未来走向:立法博弈仍将持续 目前该规则尚处于提案阶段,需经过公众评议和国会审议。环保组织已表示将发起法律挑战,而AI行业则积极游说,希望尽快落地。可以预见,这场关于“效率”与“公平”的博弈将深刻影响美国AI基础设施的布局节奏,并可能成为其他国家的政策参考。 **小结**:特朗普EPA拟议的新规试图通过集中审批权加速数据中心建设,但可能削弱社区参与和环境监督。在AI算力需求爆发的背景下,如何平衡产业发展与公共利益,将成为政策制定者面临的长期课题。
ChatGPT Voice on desktop can work with both ChatGPT Work and Codex to complete tasks and control agents.
AM/FM, NOAA weather band, solar and hand-crank charging, and a power bank - this tech is what actually works when the grid doesn't.
If you're only using Google Calendar to track events, you're missing some of its most useful features.
This is today’s edition of The Download, our weekday newsletter that provides a daily dose of what’s going on in the world of technology. Supercooled kidneys have been transplanted into pigs in a “landmark achievement”  When it comes to organ donation, time is everything. As soon as an organ has been removed from a donor’s…
“我觉得它应该叫人工白痴。”一个9岁的孩子如是说。以下是各年龄段的孩子称AI“恶心”和“ creepy”的原因。 自聊天机器人主流化四年来,营销活动铺天盖地,年轻人对大型语言模型的炒作却日益怀疑。市场研究公司YPulse的数据显示,**37%的13至17岁青少年**在看到AI生成的音乐和视频时会感到尴尬,**超过半数担忧虚假信息和深度伪造**。 年轻一代的AI态度充满矛盾。使用率很高——大多数美国青少年表示用过聊天机器人——但热情参差不齐。皮尤研究中心近期报告指出,尽管许多青少年认为AI对自己有好处,但**超过四分之一**的人认为AI将在未来20年对社会产生负面影响,担忧包括失业、批判性思维退化及环境影响。 年轻人通常热切拥抱新技术,但布法罗大学传播学教授Melanie Green表示,AI不同。这次,道德恐慌并非来自长辈——实际上,孩子们反感的是**成年人和科技公司强行推销AI的方式**。Green说,他们还“敏锐地意识到,无论发生怎样的颠覆,他们这一代都将首当其冲”。于是,白眼翻起。 在Bluesky上,家长们分享孩子对AI的不信任,称孩子回家说“那是AI”等同于“那是扯淡”。Reddit上,教育工作者指出,学生——即便使用AI——也担忧其后果,且无法忍受AI生成的艺术。 WIRED采访了年轻人、家长和教师,探究为何有些孩子不愿搭上AI的顺风车。
## 什么是 Pushary? Pushary 是一款专为提升效率而设计的工具,允许用户在锁屏状态下直接审批 AI 请求。它解决了频繁解锁设备、切换应用等繁琐操作,让 AI 工作流更加流畅。 ## 核心功能 - **锁屏审批**:无需解锁手机,即可在锁屏界面查看并批准 AI 发起的任务请求。 - **实时通知**:AI 请求以推送通知形式呈现,用户可一键处理。 - **多平台支持**:兼容主流 AI 服务,如 ChatGPT、Midjourney 等。 ## 适用场景 - **内容创作**:快速批准 AI 生成的草稿、图片修改建议。 - **自动化流程**:在 AI 代理执行任务时,及时授权关键步骤。 - **日常管理**:处理 AI 助手提出的日程安排、邮件回复等请求。 ## 行业背景 随着 AI 工具在日常工作与生活中的普及,用户需要更高效的方式与 AI 交互。传统的解锁-打开 App-确认流程打断了连续工作流。Pushary 通过锁屏交互,将审批时间从数秒缩短至瞬间,契合了“无摩擦 AI”趋势。 ## 小结 Pushary 以极简设计切入 AI 效率工具市场,其锁屏审批功能有望成为 AI 工作流的标配。对于频繁使用 AI 助手的用户,它提供了一种更直观、更快速的交互方式。

Firecrawl 近日推出了其最新版本的 `/search` 端点,宣称这是迄今为止最准确的搜索功能,同时消耗的 token 数量仅为之前的十分之一。这一改进对于依赖大规模语义搜索的 AI 应用开发者来说,意味着成本与性能的双重优化。 ## 核心升级:更准、更省 根据官方介绍,新版 `/search` 在保持 Firecrawl 一贯的网页抓取与结构化输出能力的基础上,对搜索算法进行了深度重构。**最显著的改进在于相关性排序**——系统现在能更精准地理解用户查询意图,减少无关结果的返回,从而避免下游模型浪费 token 在低质量内容上。 与此同时,**Token 效率提升了 10 倍**。这意味着同样一次搜索请求,产生的 token 数量仅为旧版的 1/10。对于按 token 计费的 API 调用场景(如 GPT-4、Claude 等),这将直接大幅降低使用成本。Firecrawl 并未公开具体的技术细节,但推测可能采用了更紧凑的摘要生成、过滤冗余文本、以及更高效的索引结构。 ## 对 AI 开发者的意义 在 AI 应用开发中,搜索与检索增强生成(RAG)是核心环节。许多应用需要从互联网实时获取信息,并将其转化为模型可消费的上下文。Firecrawl 的 `/search` 端点正是为此设计——它接受自然语言查询,返回结构化结果(如标题、摘要、元数据),开发者可直接将其注入提示词。 此前,搜索结果的 token 开销往往是瓶颈。一个典型的 RAG 流程中,搜索返回的网页摘要可能占据数千 token,而模型上下文窗口有限,且成本高昂。**Firecrawl 的更新直接缓解了这一痛点**:更少的 token 意味着可以在同一上下文中放入更多搜索结果,或者为其他任务留出空间。 ## 竞争格局与定位 Firecrawl 的主要竞争对手包括 **SerpAPI**、**Tavily** 和 **Bing Search API** 等。与它们相比,Firecrawl 强调“为 AI 而生”的端到端体验——不仅提供搜索,还内置了网页抓取、内容清洗、Markdown 转换等功能。此次 `/search` 的升级进一步强化了其性价比优势。 不过,Firecrawl 的 **免费额度有限**(每月 500 次搜索),对于高流量应用可能需要付费。但考虑到 token 节省带来的长期收益,对于需要频繁进行实时搜索的 AI 代理、研究助手或自动化工具来说,这笔投入可能是值得的。 ## 小结 Firecrawl 新版 `/search` 是一次务实的升级:**在搜索准确性和 token 效率上同时取得突破**,直接回应了开发者最关心的成本与质量难题。如果你正在构建依赖网络搜索的 AI 应用,不妨试用一下——它可能会改变你的 Token 预算分配方式。