
联邦持续学习(FCL)旨在评估分布式客户端如何从不断变化的数据流中学习,同时保留已学知识。然而,现有评估因数据集、任务划分、客户端数据分配、任务顺序、骨干网络、内存假设和报告规则等频繁同时变动而难以比较。为此,研究人员提出了 **HERO**(Heterogeneity-Aware Benchmark Library),一个面向FCL的异构感知基准库。 ## 解耦关键因素,构建可比基准 HERO的核心创新在于将通常耦合的三个选择分离:**任务划分**、**客户端数据划分**和**客户端任务序列**。在主要可比基准 **HERO-Core** 中,参数 α 控制客户端数据偏斜,ρ 控制任务顺序不匹配。这种设计使得研究者能够独立控制异构性来源,从而进行更公平的方法比较。 ## 实验设置与关键发现 研究团队在 **CIFAR-100** 和 **TinyImageNet** 上评估了代表性FCL方法,采用**最终平均准确率**、**平均遗忘率**和**底部10%客户端准确率**作为指标。此外,还包含了基于图的 **Domain-IL** 可移植性案例研究(使用 **OGB-MolPCBA** 数据集),其中支架域粒度改变输入分布,但预测任务保持不变。 实验结果揭示了几个重要现象: - 方法行为在简单和异构设置之间存在显著差异; - 平均准确率可能掩盖底层客户端的弱性能; - 任务顺序不匹配时,不同策略的表现与同步评估时截然不同; - HERO的统一接口能够暴露图像分类之外的域偏移难度。 ## 开放与可复现 HERO 提供了完整的基准流、配置、方法实现和报告脚本,以支持可重复且感知设置的FCL评估。该库通过分离异构性维度,为社区提供了更精细的评估工具,有助于推动联邦持续学习领域的标准化比较。 ## 总结 HERO 通过解耦关键变量,解决了FCL评估中缺乏可比性的核心问题。其模块化设计和丰富的实验结果不仅验证了现有方法的局限性,也为未来研究提供了清晰的方向。随着联邦学习在现实场景中的广泛应用,HERO 有望成为该领域基准测试的重要参考。
阿尔茨海默病(AD)是一种复杂的神经退行性疾病,全球数百万患者深受其影响。在疾病前驱阶段预测其向痴呆的转化,对于疾病理解和患者护理至关重要。尽管生存分析模型已被广泛应用于AD风险预测,但传统模型多为静态预测器,可解释性有限,且缺乏自然语言推理能力。针对这一痛点,最新研究提出了 **iLENS**(Interpretable LLM-Guided Mixture-of-Experts),一种融合大语言模型(LLM)与混合专家(MoE)框架的可解释生存预测方法。 ### 核心创新:LLM引导专家路由 iLENS 的核心思路是利用 LLM 处理结构化的神经影像测量数据与非结构化信息(如临床文本),并基于这些信息智能地选择最合适的“专家”模型进行生存预测。传统 MoE 通常依赖硬编码规则或简单统计特征进行专家路由,而 iLENS 借助 LLM 的语义理解能力,将路由决策转化为自然语言推理过程,从而提升预测的灵活性与可解释性。 ### 性能与可解释性兼得 实验表明,iLENS 在 AD 转化预测任务上取得了具有竞争力的性能,同时能够进行患者亚型分型。更关键的是,该框架为每一次路由决策提供了透明、生物学合理的解释,例如明确指出“海马体体积萎缩程度较高”和“APOE ε4 基因携带”等因素如何共同影响风险分层。这种可解释性弥合了高性能生存分析与临床决策支持之间的鸿沟,使模型输出更易被医生信任和采纳。 ### 临床价值与未来展望 iLENS 的提出标志着 AI 在医疗领域应用的重要进步——不再仅追求预测精度,而是将可解释性作为核心设计原则。对于阿尔茨海默病这类需要长期跟踪与个性化干预的疾病,一个既能给出风险概率,又能用自然语言说明原因的工具,将极大辅助临床医生制定早期干预策略。未来,该框架有望推广至其他神经退行性疾病,并整合多模态数据(如基因、脑脊液生物标志物),进一步拓展其应用边界。
工业物联网(IIoT)环境中,针对操作技术(OT)的网络攻击正日益造成昂贵的停机时间和物理损坏,传统基于规则的监控方法已显露出局限性。尽管大语言模型(LLM)具备强大的语义推理能力,可辅助决策支持,但其固有的幻觉特性在闭环控制场景中构成不可接受的安全风险。 **新框架:神经-智能体控制** 近期一篇预印本论文提出了**神经-智能体控制框架**,这是一种将LLM规划器(如 Gemini 2.5 Flash-Lite)与预训练的**时间序列基础模型(TimesFM)** 相结合的新型架构,旨在实现基于物理规律的自主防御。其核心创新在于引入了一种**“反事实物理注入机制”**:在LLM提出的干预措施实际执行前,先在基础模型的数值潜在空间中模拟其影响,从而允许系统拒绝幻觉或不安全的行为。 **实验验证:显著优于传统基线** 研究团队在工业数据集(如安全水处理系统 SWaT)上,针对随机攻击场景进行了评估。结果显示,该框架相比 LSTM 和 TCN 基线表现更优: - **神经-智能体循环**成功阻止了 **33.3%** 的阈值以下违规事件(5次),而 LSTM 和 TCN 的阻止率分别为 26.7% 和 13.3%。 - 更关键的是,**零次**物理上无效(即幻觉)的动作被执行。 **行业意义:基础模型作为“哨兵”** 这些结果证明了将基础模型用作确定性“哨兵”来保护关键基础设施中智能体AI的有效性。该框架通过“先模拟后执行”的机制,有效解决了LLM在工业控制场景中的幻觉问题,为AI在安全攸关领域的落地提供了新思路。 目前该研究以预印本形式发布于 arXiv,尚未经过同行评审。
对抗鲁棒性是AI安全的核心问题之一,但现有方法往往只能提供“局部”保证。近日,一篇来自arXiv的论文(编号2607.08773)提出了一种全新的理论框架,将多层感知机(MLP)的对抗鲁棒性问题转化为**格遍历问题**,并首次系统定义了“完备认证”概念,为可验证AI安全性开辟了新路径。 ## 问题背景:从“声音”到“完备” 传统对抗鲁棒性研究关注的是:给定一个输入点 x,能否找到一个尽可能大的区间(即轴对齐超矩形),使得 x 在该区间内任意扰动都不会改变MLP的分类结果?这类区间被称为**声音认证**(Sound Certification)。然而,论文作者指出,这种认证只回答了“哪里安全”,却没有回答“哪里不安全”。 为此,他们引入了**完备认证**(Complete Certification)的概念:一个区间 I 是完备认证,当且仅当 x ∈ I,且一旦 x 移出 I,MLP的预测**必定**改变。换句话说,完备认证精确刻画了分类决策的“边界”。 ## 核心方法:格遍历与“细化-验证”迭代 论文的核心洞察在于:所有可能的候选区间构成一个**格**(Lattice),每个格元素对应一个区间。对抗鲁棒性问题因此等价于在这个格上寻找满足特定性质的元素。 作者设计了专用的**格遍历算子**,并采用“细化-验证”(Refine & Verify)迭代方案: - 在每一轮,算法生成一个候选区间; - 利用形式化MLP验证器(如基于SMT或MILP的求解器)检查该区间是否满足声音或完备条件; - 若满足,则尝试扩大(声音)或缩小(完备)区间,继续遍历; - 直到找到最大声音区间或最小区间。 该方案保证了**声音最大性**(即找到的区间是最大的声音区间)和**完备最小性**(即找到的区间是最小的完备区间)。 ## 不对称性:优化问题的复杂度差异 论文进一步研究了优化问题,发现了有趣的不对称性: - 对于**完备认证**,最小解可以在多项式次oracle调用内求得; - 对于**声音认证**,问题被证明是强难解的(strongly intractable)。 这一结果揭示了两种认证在计算本质上的差异:寻找“安全边界”比寻找“分类边界”更难。 此外,对于对称区间(即 ℓ∞-球),作者给出了对数复杂度的算法,显著提升了效率。 ## 实验验证:ParallelepipedoNN系统 作者实现了名为 **ParallelepipedoNN** 的系统,并在多个标准MLP模型上进行了评估。实验表明,该方法能够有效生成最大声音区间和最小完备区间,且计算开销在可接受范围内。 ## 意义与展望 这项工作的意义在于: 1. **理论统一**:将对抗鲁棒性纳入格论的框架,为后续研究提供了数学基础。 2. **完备认证首次定义**:补全了AI安全性验证的“另一半”,使认证不仅告诉用户“哪里安全”,更明确“哪里不安全”。 3. **复杂度分类**:清晰划定了不同认证问题的计算边界,指导实际算法设计。 未来,该框架有望扩展到卷积神经网络、Transformer等更复杂的架构,并与其他形式化验证方法结合,推动可验证AI从理论走向工程应用。
## 核心发现:耦合不仅是计算选择,更是对齐接口 在生成模型中,**流匹配(Flow Matching)** 通过定义噪声向量与数据点之间的配对规则(即耦合)来学习概率路径。传统上,这种耦合被视为纯粹的计算选择。然而,近日发表于 arXiv 的一篇论文《Reward Transport: Property Control in Flow Matching via Noise-Space Alignment》提出了一个颠覆性观点:**耦合可以作为一种对齐接口**——通过根据目标分子属性匹配噪声与数据,可控结构被直接嵌入到学习到的流场中。 ## 方法:Reward Transport 的机制 基于这一洞察,研究团队引入了 **Reward Transport** 方法。其核心思想是:在训练阶段,使用最优传输(Optimal Transport)耦合将**标量噪声空间坐标**与分子奖励(如 logP、QED)对齐。在推理时,通过简单地改变这个噪声坐标,即可引导生成分布向高奖励区域偏移,**无需依赖 Oracle 模型、奖励模型、梯度引导或额外计算**。 值得注意的是,在耦合保持的极限情况下,对该坐标进行阈值化可以恢复**交叉熵方法(Cross-Entropy Method)** 的截断奖励分布,从而提供一个原理清晰、连续可调的分布级控制旋钮。 ## 实验验证:单调控制与特异性响应 实验在 **ZINC-250K** 和 **GuacaMol** 基准上进行。结果表明,通过扫描标量噪声坐标,模型实现了对 logP 的单调控制,以及对 QED 在其操作范围内的一致控制。最令人印象深刻的是,**同一个旋钮对不同目标产生了相反的结构响应**:对于 logP 倾向于生成更大的分子,而对于 QED 则倾向于更小的分子——这排除了简单的大小偏差干扰。 ## 与现有方法的兼容性与局限性 Reward Transport 与无分类器指导(Classifier-Free Guidance)和条件流匹配是互补的。然而,论文也报告了一个负面结果:在 epsilon 预测扩散(epsilon-prediction diffusion)下,该方法失效,这恰好说明了**耦合级别对齐的结构缺失**。 ## 行业意义与未来方向 这项工作为**分子生成中的属性控制**提供了一种轻量级、无需额外训练的解决方案,有望加速药物发现和材料设计中的逆向优化。其核心思想——利用耦合作为对齐接口——也可能启发其他生成任务(如图像、文本)中的可控生成方法。 论文代码已开源,感兴趣的读者可进一步探索。
混合专家模型(MoE)凭借其稀疏激活特性,已成为大语言模型主流架构之一。但在分布式推理场景中,如何高效地将不同专家(Expert)分配到各GPU上,始终是影响端到端延迟的关键瓶颈。现有方案多基于历史请求的专家激活模式进行静态或离线优化,面对多样且快速变化的请求流量时显得力不从心。 最新发表于arXiv的论文《Director: Accelerating Distributed MoE Serving via Online Proactive Expert Placement》提出了一套全新的在线主动式专家放置框架,旨在从根本上解决这一挑战。该研究已被INFOCOM 2026接收。 ### 核心挑战与设计思路 Director的设计围绕三大难点展开: - **请求的专家激活模式存在不确定性**,无法提前预知每个请求会触发哪些专家; - **专家迁移本身有成本**,频繁移动专家会引入额外通信开销与服务中断; - **放置优化是NP难问题**,在大规模集群中寻找最优解几乎不可能。 为此,Director采用**预测驱动、在线迁移**的策略。系统首先通过一个轻量级级联预测器(cascaded predictor)或低位量化副本(low-bit quantized replica),对即将到来的请求进行专家激活模式预测。随后,在线迁移模块在计算密集阶段(compute-bound phase)执行专家迁移,将服务中断时间降至接近零。 ### 松弛优化的数学保证 在优化器层面,Director设计了一个基于松弛(relaxation-based)的在线放置算法,在容量约束下运行于多项式时间,并实现了 **(1+ε) 近似比**的数学保证。这意味着算法能在有限时间内给出接近理论最优的放置方案,兼顾了效率与质量。 ### 实测效果:端到端延迟降低11%~55% 研究团队在主流MoE模型(包括Mistral、DeepSeek、Qwen)上进行了全面实验。结果表明,相比现有最优的专家放置方案,Director将端到端推理延迟降低了 **11%至55%**。这一提升在请求模式剧烈波动时尤为显著,验证了主动预测+在线迁移的有效性。 ### 行业启示 随着DeepSeek-V3、Qwen2.5-MoE等模型在工业界广泛应用,MoE服务的部署效率直接关系到成本和用户体验。Director提出的“预测+在线调整”思路,跳出了传统静态优化的框架,为分布式推理系统提供了新的设计范式。特别是在多租户、高并发场景下,这种自适应能力可能成为未来推理引擎的标配。 不过,该方案仍处于原型阶段,预测器的额外开销、大规模集群下的迁移调度策略等细节还有待进一步工程验证。但无论如何,Director已经为MoE服务系统指明了一条值得深入探索的技术路径。
## 解决流形归一化的通用难题 在机器学习中,流形值数据(如对称正定矩阵、旋转矩阵)广泛出现在视觉、机器人、医学成像等领域。虽然深度神经网络已能处理这些非欧几里得数据,但如何有效归一化流形上的样本分布仍是难题。现有黎曼归一化方法多针对特定流形设计,缺乏通用性,且难以真正控制分布均值和方差。 ## LieBN:统一李群上的归一化 为突破这一瓶颈,来自意大利特伦托大学、中国江南大学等机构的研究者提出了 **LieBN**,一个基于李群理论的黎曼批量归一化框架。李群是同时具有群结构和光滑流形结构的数学对象,典型例子包括旋转群 SO(3)、对称正定矩阵群等。LieBN 的核心思路是利用李群上天然存在的**左不变和右不变度量**——这些度量在群作用下保持几何性质不变,从而为归一化提供理论保障。 ## 九种几何实例与创新度量 研究团队在九种不同几何结构上实例化了 LieBN: - **SPD 流形**(对称正定矩阵):四种度量,包括一种新提出的右不变度量,以及通过矩阵幂变形扩展的三种李群结构 - **旋转矩阵群 SO(3)**:一种度量 - **满秩相关矩阵流形**:四种度量 值得注意的是,在 SPD 流形上,研究者引入了一种全新的 **右不变度量**,并利用矩阵幂变形技术将三种现有黎曼度量转化为李群结构,极大丰富了可选的几何工具。 ## 理论保证与实验验证 LieBN 提供了理论上的保证:通过左/右不变度量,归一化过程能有效控制黎曼均值与方差,避免传统方法中分布偏移的问题。实验在多种流形任务上验证了 LieBN 的有效性,表明其优于现有的特定流形归一化方法。代码已开源。 ## 意义与展望 LieBN 为流形深度学习提供了一个统一、可扩展的归一化解决方案。它不仅简化了不同流形上归一化方法的设计,也为处理更复杂的结构(如李群上的图神经网络、时间序列建模)奠定了基础。未来,该框架有望在计算机视觉、机器人操控、医学图像分析等需要处理流形数据的领域发挥作用。
在 7 月 12 日的马德里 Real Cool 音乐节上,歌手 Lorde 在演出间隙突然对 AI 眼镜开火。虽然没有点名具体品牌,但她的矛头显然指向了音乐节赞助商 Ray-Ban 与 Meta 合作的 AI 智能眼镜。 “你不知道别人戴的是太阳镜,还是那些该死的……让我说清楚,去他妈的眼镜。别买,一点都不性感。”Lorde 在感谢观众参与“真实”体验后,突然插入了这段即兴吐槽。现场视频被迅速传上社交网络,引发热议。 有趣的是,当天稍后登台的 Blackpink 成员 Jennie 恰好是 Ray-Ban Meta AI 的代言人,她此前在 Instagram 和音乐节间隙播放的视频中为该产品站台。一前一后的“对立”发言,让这场音乐节多了几分戏剧性。 **Lorde 的批评并非孤立事件**。Meta 的智能眼镜近期正面临越来越大的舆论压力。尽管争议不断,但据 The Verge 报道,Meta 仍在计划推出一款名为“超级感知”的新眼镜,支持持续录像,隐私担忧或将进一步升级。 从技术角度看,Ray-Ban Meta AI 眼镜集成了摄像头、麦克风和 AI 助手,可以拍照、录像、听音乐、接电话,甚至通过 AI 识别物体和翻译文字。然而,正是这些“智能”功能引发了公众对隐私的担忧——在别人不知情的情况下被录制,让很多人感到不安。Lorde 的“不性感”评价,恰恰戳中了科技产品在公共场合的社会接受度痛点。 **这场争论背后,是科技便利与个人隐私的经典博弈**。当可穿戴设备越来越“隐形”,社会规范却远未跟上。Lorde 的直言不讳,或许会让更多人停下来思考:我们真的需要随时随地被记录吗?而 Meta 的回应,以及市场最终的选择,将决定这类产品的未来。
## 从JUCE到Juggler:一位资深C++开发者的AI新尝试 如果你对音频开发领域有所了解,那么你一定听说过 **JUCE**——这个由 **Jules Storer** 创建的跨平台C++框架,几乎是音频插件和桌面音乐应用开发的事实标准。如今,这位在C++领域深耕30多年的老将,带着他的新项目 **Juggler** 重回聚光灯下。 Juggler 是一款**开源的GUI编码代理**,它的目标很明确:让AI能够理解并操作图形用户界面。与市面上那些专注于生成代码片段或处理后端逻辑的AI编码助手不同,Juggler 试图解决一个更具体、也更棘手的问题——**如何让AI像人类开发者一样,在视觉层面上构建和修改界面**。 ### 为什么是GUI? 在AI编码代理领域,我们见过Copilot,见过Cursor,也见过各种基于LLM的代码生成工具。但大多数工具的工作流是“文本进,文本出”——你描述需求,它生成代码,然后你手动将代码粘贴到编辑器中,再运行查看效果。这种模式对于后端逻辑或纯算法任务或许足够,但在图形界面开发中,效率瓶颈极其明显。 Juggler 的切入点正是这个痛点。它试图创建一个**能够“看见”并操作UI的代理**。你可以给它一个视觉目标(比如“在窗口右上角添加一个蓝色按钮”),它会自动解析当前界面布局,生成对应的修改代码,并直接应用到界面上。这种“所见即所得”的交互方式,有望大幅降低GUI开发的门槛。 ### 技术背景与行业意义 作为JUCE的创造者,Jules 对GUI框架的底层机制了如指掌。JUCE 本身就是一个高度抽象化的C++ GUI库,被广泛应用于音频插件、数字音频工作站和各类桌面应用。Juggler 很可能是基于类似的架构理念,但将AI代理作为核心交互层。 从行业角度看,Juggler 的出现反映了AI编码工具的一个重要趋势:**从“代码补全”走向“视觉理解”**。传统的AI代码补全(如GitHub Copilot)擅长推断下一行代码,但缺乏对整体布局和视觉效果的感知。而Juggler 这类工具,则需要模型具备**多模态理解能力**——既要读懂代码,又要理解UI截图或渲染后的图形状态。 ### 开源与社区驱动 Juggler 以开源方式发布,这并非偶然。Jules 在JUCE上的成功很大程度上归功于其活跃的社区和开放生态。通过开源,Juggler 可以快速吸引开发者贡献代码、测试用例和UI场景,加速迭代。对于AI代理而言,**训练数据的多样性和质量至关重要**,而开源社区恰好能提供丰富的真实GUI应用案例。 ### 挑战与展望 当然,Juggler 面临的挑战也不小。GUI开发涉及大量的状态管理、事件处理和平台差异,AI代理要准确理解这些,需要非常强大的上下文建模能力。此外,如何确保AI生成的UI代码不会破坏现有功能,也是实际落地前必须解决的问题。 不过,对于这样一位拥有30多年开发经验、且成功打造过行业标准工具的老将来说,Juggler 至少是一个值得关注的方向。如果它能将JUCE时代的“开发者友好”理念带入AI代理领域,或许我们很快就能看到新一代的“GUI编程助手”诞生。 > 目前Juggler仍处于早期阶段,更多技术细节和实际演示可在其GitHub仓库中找到。我们也将持续关注这个项目的进展。
开发者社区最近出现了一项有趣的对比测试:在读取用户提示之前,**Claude Code** 会先发送约 **33,000 tokens** 的上下文数据,而 **OpenCode** 仅需 **7,000 tokens**。这一差异直接影响了 API 使用量和成本。 ## 发现过程 测试始于一个直觉:团队通常使用 OpenCode,但近期因 Meridian 问题被迫转向 Claude Code。在使用过程中,他们发现 Claude Code 的 token 消耗速度远快于 OpenCode。为验证这一猜测,团队进行了定量测试。 ## 测试方法 测试方式很简单:向两个工具发送相同的简单提示(例如“列出当前目录的文件”),并记录它们在真正读取用户输入之前发送的 token 数量。结果差异显著: - **Claude Code**:约 33,000 tokens - **OpenCode**:约 7,000 tokens 这 26,000 tokens 的差距意味着每次交互 Claude Code 会多产生近 **4 倍** 的预读开销。 ## 影响分析 对于高频用户或依赖 API 的企业,这种 token 浪费会迅速累积。假设每次交互多消耗 26k tokens,以常见 API 定价计算,每月数万次交互可能导致数百美元的额外成本。更重要的是,它反映了两种工具在设计哲学上的不同: - **Claude Code** 倾向于加载大量系统提示、示例和工具定义,以确保模型有充分的上下文,但牺牲了效率。 - **OpenCode** 采用更精简的预加载策略,仅在需要时扩展上下文,降低了每次请求的基础开销。 ## 行业背景 在 AI 编程助手领域,token 效率是核心竞争力之一。随着模型上下文窗口不断扩大(如 Claude 3 的 200K、GPT-4 Turbo 的 128K),开发者容易忽视预加载开销。然而,对于实际生产环境,**token 消耗直接等于成本**。 这一发现也提醒开发者:在选择 AI 工具时,不仅要关注模型能力,还应关注客户端实现效率。未来,开源项目如 OpenCode 可能通过更透明的 token 使用策略吸引成本敏感用户,而商业产品则需在“智能”与“经济性”之间找到平衡。 ## 小结 Claude Code 与 OpenCode 在预读 token 上的 4 倍差距,为开发者提供了一个实用的成本考量维度。建议团队在评估工具时,进行类似的 token 审计,避免“隐形成本”侵蚀预算。
## 当因果推理遇上大模型:机械可解释性的新方向 在深度学习黑箱问题日益突出的今天,机械可解释性(Mechanistic Interpretability)领域正迎来一个重要转向:研究者开始系统性地将**因果理论**应用于大语言模型(LLMs)的分析中。一篇发表于 arXiv 的论文(2301.04709)正是这一趋势的代表作,它尝试用因果形式化方法来拆解 LLM 的内部计算机制,为理解这些庞然大物的“思维过程”提供了全新视角。 ### 从相关到因果:可解释性的范式跃迁 传统上,可解释性方法大多停留在“相关性”层面——例如通过注意力权重可视化或特征归因来找出哪些输入对输出影响大。但相关性不等于因果,尤其在 LLM 这样高度非线性的系统中,一个 token 的激活可能只是与最终输出相关,而非真正驱动了它。 因果理论的优势在于,它能区分“关联”与“干预”。研究者通过构建**因果图**(causal graph)来建模 LLM 内部的激活路径,然后使用**干预实验**(如激活修补、路径修补)来验证哪些计算节点是特定行为的关键。这种思路将神经网络的内部计算视为一个因果系统,其中每一层、每一个注意力头都可能是一个“变量”,而它们的相互作用构成了因果链条。 ### 论文核心思路:形式化因果模型 该论文提出了一种框架,将训练好的 LLM 转化为一个**结构化因果模型**(SCM)。具体来说: - **节点**:模型的组件(如注意力头、MLP 层)被定义为变量,其值为该组件的激活向量。 - **边**:数据流方向——即前向传播中的连接关系。 - **干预**:通过“放置”或“删除”特定组件激活来模拟因果效应。 例如,研究者在 GPT-2 上测试了“间接效应”的概念:当一个注意力头从较早层复制信息到较晚层时,这种“信息路由”是否对最终输出产生因果影响?通过干预实验,他们发现许多看似重要的注意力头其实可以被“剪掉”而不影响预测,而少数几个关键头才是真正负责推理的因果节点。 ### 行业意义:更安全、更可控的 AI 这一研究方向对 AI 安全至关重要。当前 LLM 的“幻觉”、偏见和对抗脆弱性很大程度上源于我们对模型内部机制的无知。如果能够用因果理论精确定位导致错误行为的**最小因果回路**,就可以有针对性地修复模型,而不是靠全网微调来“碰运气”。 此外,因果可解释性还为实现**模型编辑**(model editing)提供了理论基础。例如,通过修改因果图中的某个节点权重,可以精确改变模型对特定事实的记忆,同时不影响其他能力——这正是知识编辑技术(如 ROME、MEMIT)的底层原理。 ### 挑战与展望 尽管前景光明,但将因果理论应用于 LLM 仍面临巨大挑战: - **计算开销**:每个干预实验都需要一次完整的前向传播,对于千亿参数模型来说代价极高。 - **因果图规模**:LLM 的组件数量(注意力头×层数)可达数万个,构建完整因果图几乎不可能,需要自动化的子图发现方法。 - **非线性与交互**:组件间的交互并非简单的线性因果,可能存在高阶效应,现有因果框架难以完全捕捉。 不过,该论文的贡献在于提供了一个**形式化起点**。未来,随着更高效的干预技术和自动化因果发现工具的发展,机械可解释性有望从“事后归因”走向“事前预测”,真正成为 LLM 设计与部署的标配环节。 > 一句话总结:因果理论为 LLM 可解释性提供了严谨的数学语言,让“黑箱”逐渐透明——尽管路还很长,但方向已经明确。
近日,OpenAI发布了GPT-5.6系列模型,其中旗舰版Sol在性能上取得了显著突破。AI代理平台Ploy在将其生产级代理从Claude Opus迁移至GPT-5.6 Sol后,获得了令人瞩目的成果:任务完成速度提升2.2倍,成本降低27%,且质量不输甚至超越原有模型。 Ploy的代理负责构建和编辑真实的营销网站,从规划页面、读取代码库、编写组件到生成图像、截图自查,整个流程对模型能力要求极高。过去四个月,Claude Opus一直占据默认模型的位置,而GPT-5.6是首个在严格评测中超越它的大模型。 然而,迁移过程并非一帆风顺。团队发现,许多看似属于“模型”的行为,实际上是提供商特有的,比如工具参数的填充方式、提示缓存的机制、以及推理过程的重放。这些差异导致初始评估失败频发,迫使团队逐一调整:修复评估框架、优化工具模式、调整缓存策略、改进推理重放逻辑。 这一案例揭示了AI行业的一个普遍现象:**评估框架往往在不知不觉中偏向现有模型**。团队使用的工具调用预算、提示缓存大小等参数,都是针对Claude Opus优化的,切换到GPT-5.6后必须重新校准。 Ploy的迁移经验为行业提供了宝贵参考:在评估新模型时,不能直接套用原有基准,而应建立中立、全面的评测体系。同时,模型选择需结合具体任务需求——速度与成本的提升固然重要,但必须确保核心质量不下降。 随着GPT-5.6的发布,AI代理领域可能迎来新一轮升级浪潮。对于追求高性能、低成本的企业而言,GPT-5.6 Sol无疑是一个极具吸引力的选择。但迁移过程需谨慎,避免因忽视底层差异而导致性能损失。
苹果的自动驾驶汽车项目虽然最终搁浅,但它在芯片领域留下的遗产正在成为AI时代的关键武器。据彭博社马克·古尔曼(Mark Gurman)在最新一期《Power On》通讯中透露,早期为汽车平台研发的AI处理器虽然从未量产,却直接催生了至今仍在进化的**神经网络引擎(Neural Engine)**,并推动了苹果加速开发支持**1.5TB内存**的M7 Ultra芯片。 ## 从汽车处理器到神经网络引擎 早在2010年代中期,苹果秘密推进“泰坦计划”(Project Titan)时,团队就意识到自动驾驶需要强大的**端侧AI处理能力**。当时,云端AI尚不成熟,车载场景对实时性和隐私的要求极高。为此,苹果内部开始设计专门用于神经网络计算的协处理器。虽然汽车项目最终因战略调整而终止,但这项技术积累被移植到了移动端——2017年,**A11 Bionic芯片**首次搭载神经网络引擎,主要服务于Face ID、Animoji和AR功能。 这一决策让苹果在AI硬件布局上抢占了先机。当竞争对手仍在依赖云端或通用GPU时,苹果已经将专用AI单元集成到iPhone、iPad乃至Mac的**M系列芯片**中。正是这种端侧能力,让苹果得以强调其隐私优势:大量AI运算在本地完成,无需将用户数据上传至云端。 ## 全面押注AI硬件:跳过M6,直奔M7 Ultra 尽管苹果在AI软件(如Siri、生成式AI)方面常被批评落后于谷歌和微软,但其硬件路线图显示出前所未有的激进。古尔曼报道称,苹果将跳过M6系列的Pro、Max和Ultra版本,直接加速开发**M7芯片**,预计2027年上半年推出。M7系列将配备大幅升级的神经网络引擎,而**M7 Ultra**更是计划支持高达**1.5TB的统一内存**——这一容量远超当前多数AI服务器,暗示苹果可能将其用于自研服务器芯片,以支撑更复杂的云端AI推理任务。 此举意味着苹果不再满足于端侧AI,而是试图打通从设备到服务器的全栈AI基础设施。通过统一内存架构,M7 Ultra可以在单芯片上处理超大规模模型,减少数据在CPU、GPU和NPU之间的搬运延迟。 ## 行业启示:失败项目的意外收获 苹果造车项目的折戟曾被外界视为战略失误,但它在芯片研发上的“副产物”正在重塑AI竞争格局。与谷歌的TPU、英伟达的GPU不同,苹果走的是**端云协同**路线:端侧芯片处理低延迟、隐私敏感的任务,服务器芯片则承担重型计算。这种双轨策略既延续了苹果对用户隐私的承诺,又为即将到来的“AI iPhone”时刻储备了算力。 对于开发者而言,M7 Ultra的1.5TB内存意味着可以在本地运行接近GPT-4规模的模型,这将催生新的应用形态——从实时语音翻译到本地视频生成,都可能成为现实。 ## 小结 苹果的汽车项目虽然从未驶上公路,但它留下的神经网络引擎和即将到来的M7 Ultra,正在为AI行业铺设一条新的高速公路。如果说A11芯片是AI端侧计算的起点,那么M7 Ultra或许将定义下一个十年的AI基础设施。
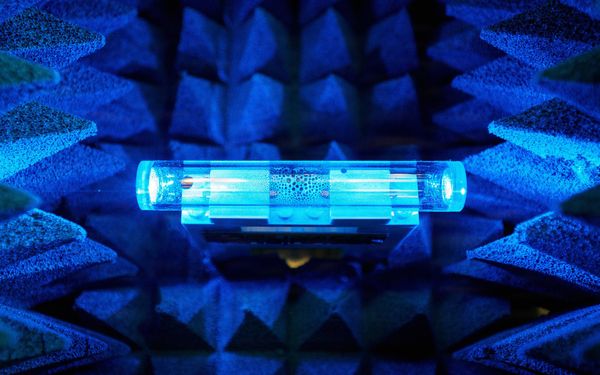
美国陆军研究实验室(ARL)近日展示了一款基于里德伯原子的量子传感器,能够以三维方式探测无线电信号,而整个设备的尺寸仅相当于一枚回形针。这项突破有望大幅缩小通信和雷达系统的体积,并为军事和民用领域带来新的应用可能。 ## 工作原理:里德伯原子的“超敏”天赋 传统天线依赖于金属结构中的电子振荡来接收电磁波,其尺寸通常需要与信号波长相当。而ARL开发的传感器则利用被称为“里德伯原子”的特殊原子态——当原子被激光激发到高能级时,其电子轨道半径急剧增大,对外界电场变得极为敏感。这种原子蒸气被封装在一个微小的玻璃腔室内,当无线电信号通过时,会改变原子的能级状态,通过光学方法即可精确探测信号的频率、幅度和方向。 ## 三维探测能力:突破平面限制 与现有量子传感器大多只能探测一维或二维信号不同,ARL的新设计通过多束激光的巧妙布局,实现了对信号源三维空间位置的定位。这意味着该设备不仅能检测信号的存在,还能判断其来自哪个方向,甚至追踪移动中的发射源。这一能力在军事通信、电子战和频谱监测中具有重要价值。 ## 尺寸与性能的颠覆性平衡 ARL的研究人员表示,这款传感器的核心部件——包含铷原子蒸气的玻璃腔——长度不足1厘米,整个原型系统(包括激光器和光路)可集成到约火柴盒大小的模块中。相比之下,传统天线要达到同等灵敏度,往往需要数米甚至数十米的尺寸。尽管目前该设备的探测距离和频段覆盖仍有待优化,但团队相信通过改进激光技术和原子封装工艺,未来可实现便携式、低功耗的量子接收机。 ## 行业背景与潜在影响 量子传感是近年来量子技术领域的热点之一。与传统传感器相比,量子传感器在灵敏度、分辨率和抗干扰能力上具有理论优势。此次ARL的成果标志着量子传感器从实验室概念向实用化迈出了关键一步。在民用领域,这种微型量子天线可用于5G/6G通信基站、物联网设备以及无线电频谱监测;在军事领域,则可能用于隐形通信、雷达对抗以及无人系统的小型化。 ## 挑战与展望 目前该传感器仍处于原型阶段,主要挑战包括: - 需要精确调谐的激光系统,增加了功耗和成本; - 对振动和温度变化敏感,需要稳定的工作环境; - 信号动态范围和噪声水平需进一步优化。 不过,随着集成光学和原子芯片技术的发展,这些问题有望在未来几年内得到解决。ARL计划下一步将传感器与小型化激光器和控制电路集成,打造完全自足的量子接收机模块。
This is The Stepback, a weekly newsletter breaking down one essential story from the tech world. For more on the data center buildout, follow Emma Roth. The Stepback arrives in our subscribers' inboxes on Sunday at 8AM ET. Opt in for The Stepback here. How it started Years before the AI boom threatened local power […]
Researchers cobbled together funding and time to show how quantum computing could aid in the development of drugs to help underserved populations and combat rare diseases.
I tested Google Workspace, Proton Mail, Microsoft 365, Fastmail, and Spike to find the best email hosting for freelancers and remote teams in 2026.
在信息爆炸的时代,传统搜索引擎往往让人迷失在海量链接中,而 **JustVibe** 试图给出一个不同的答案——它将自己定义为“**用于行动的搜索引擎**”,并且内置了一系列专为你打造的应用。 ## 从搜索到执行:JustVibe 的核心理念 JustVibe 的独特之处在于,它不再仅仅满足于返回信息列表,而是直接提供能帮你完成任务的工具。想象一下,当你搜索“写一封商务邮件”时,它不再只展示邮件模板网站,而是直接调用内置的写作应用,让你在同一个界面内完成创作。这种“**搜索即服务**”的模式,大幅缩短了从意图到执行的路径。 ## 内置应用生态:为常见场景量身定制 JustVibe 内置了多款应用,覆盖了工作、学习和日常生活的常见需求。例如: - **写作助手**:基于 AI 快速生成文案、大纲或邮件。 - **任务管理器**:将搜索到的待办事项直接转化为可跟踪的任务列表。 - **信息整理器**:自动提取网页关键信息并结构化呈现。 这些应用并非简单的外挂工具,而是与搜索深度耦合——搜索结果可以直接“喂”给应用,实现无缝流转。 ## 对行业的意义:搜索引擎的范式转变 当前 AI 搜索引擎(如 Perplexity、Google SGE)主要聚焦于**问答式搜索**,即用大模型生成答案。而 JustVibe 则更进一步,将搜索从“**获取信息**”推向“**完成任务**”。这背后反映的是 AI 应用从知识检索向智能代理演进的趋势。 不过,JustVibe 目前仍处于早期阶段,其应用生态的丰富度和搜索结果的准确性还有待市场检验。如果它能够持续扩展内置工具的种类,并优化底层搜索质量,或许能开辟一条区别于传统搜索引擎的新赛道。 ## 小结 JustVibe 的“行动搜索引擎”概念,为 AI 搜索领域带来了新的想象空间。它不再只是信息的入口,更是行动的起点。对于追求效率的用户而言,这种“搜完即用”的体验可能正是他们需要的。
## 当创意遇上智能记忆:Miora 重新定义创作边界 在 AI 驱动的创意工具层出不穷的今天,**Miora** 以“可编辑画布上的智能体记忆”这一独特定位切入市场,试图解决创作者在规模化创意过程中面临的核心痛点:灵感碎片化、上下文丢失以及协作效率低下。 ### 可编辑画布:不只是画板,更是创意工作流 传统的数字画布往往只是静态的创作空间,而 Miora 的“可编辑画布”则更像一个动态的智能工作台。用户可以在画布上自由排列、连接各类元素——从文本、图像、代码片段到 AI 生成的建议——并随时修改和重组。这种灵活性让创作者能够以非线性方式探索想法,无需担心初始结构限制。 ### 智能体记忆:让 AI 真正理解你的创作脉络 Miora 的亮点在于其**智能体记忆**机制。不同于普通 AI 工具只能处理单次对话或当前项目,Miora 能够记住用户在不同画布上的创作历史、偏好和决策逻辑。这意味着当你开始一个新项目时,AI 可以基于过往的创作风格和内容积累提供更贴切的建议,甚至自动补全未完成的思路。这种“记忆”不仅限于个人,还可跨团队共享,确保协作中的上下文连贯性。 ### 规模化创意:从灵感到落地的加速器 对于内容创作者、设计师和产品团队而言,Miora 的价值在于它能够将零散的创意快速转化为可执行的方案。通过画布上的拖拽操作与 AI 辅助,用户可以: - 快速生成多个创意变体,并在画布上并排对比; - 利用记忆功能回溯之前的优秀方案,避免重复劳动; - 在团队协作中,让每个成员都能看到创意的演进脉络。 ### 行业背景与竞争格局 当前,AI 创意工具市场已相当拥挤,从 Midjourney 的图像生成到 Notion AI 的文档辅助,各有侧重。但 Miora 的差异化在于它并非单一功能工具,而是一个**以画布为核心、记忆为纽带**的创意操作系统。这种设计更接近“AI 版 Figma”或“智能化的 Miro”,但加入了长期记忆这一关键维度。 不过,Miora 也面临挑战:如何确保记忆的准确性和隐私安全?如何让用户愿意逐步建立并信任 AI 的记忆?这些问题的答案将决定它能否从概念走向主流。 ### 小结 Miora 的出现,标志着 AI 创意工具正从“一次性生成”向“持续协作与记忆”演进。对于追求高效与创新的团队来说,它或许正是那个能打破创意瓶颈的下一块拼图。
在 AI 工具日益碎片化的今天,如何让智能助手真正“记住”你的上下文,成为提升效率的关键。**Second Brain for AI v2** 正是为解决这一痛点而生——它不是一个独立的聊天机器人,而是一个跨平台的 AI 记忆层,能够在你使用的各种工具之间**自动连接信息碎片**,形成连贯的知识图谱。 ## 核心能力:跨工具记忆 传统 AI 助手通常只能在单一应用内保持会话记忆,一旦切换工具或关闭窗口,之前的对话历史便成为孤岛。Second Brain for AI v2 通过插件或 API 集成到 Slack、Notion、Chrome 等常用工具中,**实时同步你的交互数据**,并利用向量数据库构建长期记忆。例如,你在 Slack 中讨论的某个项目方案,可以在后续通过 Notion 调用时被自动引用,无需重复描述背景。 ## 技术亮点:图谱式关联 与简单的日志记录不同,v2 版本引入了**关系推理引擎**。它不仅能存储事实,还能识别不同信息之间的隐性关联——比如将邮件中的客户需求、会议中的决策要点、代码仓库的更新日志串联起来,生成一个动态更新的“工作记忆图”。这种能力尤其适合需要跨部门协作、多任务并行的团队场景。 ## 落地场景与价值 - **个人知识管理**:研究者或写作者可以利用它自动整理分散在浏览器、笔记软件和文档中的灵感片段,形成结构化的知识库。 - **团队协作**:项目经理无需手动同步各平台状态,AI 记忆层会自动汇总进度、标注冲突点,并生成周报摘要。 - **自动化工作流**:结合 Zapier 等工具,记忆数据可作为触发条件,例如当记忆库中出现“客户投诉”关键词时,自动创建工单并通知负责人。 ## 行业背景与展望 当前 AI 应用正从“单点工具”向“智能体生态”演进。OpenAI 的 GPTs 和 Google 的 Project Jarvis 都在探索跨应用记忆,但 Second Brain for AI 选择了更轻量的**记忆中间件**路线——不绑定特定模型,而是作为数据管道连接现有工具。这种设计使其兼容性更强,也更容易被现有工作流采纳。 不过,跨工具记忆也带来了隐私与安全挑战。用户需要明确知晓哪些数据被记录、如何被使用。Second Brain for AI v2 提供了**本地优先的加密选项**,允许用户控制记忆的存储位置和共享范围,这是其在企业级场景落地的关键。 总的来说,**Second Brain for AI v2** 瞄准了 AI 应用中的“记忆断层”问题,通过非侵入式的跨工具集成,让智能真正连贯起来。对于重度依赖多个数字工具的团队和个人,它有望成为提升认知效率的“隐形助手”。