
在对抗性机器学习领域,投影梯度下降(PGD)攻击是评估模型鲁棒性的标准方法。然而,传统上仅依赖最终对抗精度来评判模型,忽略了攻击过程中模型行为的动态变化。近期研究提出轨迹级诊断指标,如损失演化、梯度对齐和失败步数,旨在提供更深入的优化动力学洞察。但这些指标是否可靠地反映鲁棒性强度,尚不明确。 一篇新论文对Fashion-MNIST上的卷积神经网络进行了PGD攻击的轨迹级研究,比较了干净训练和对抗训练模型在不同鲁棒性水平下的表现。研究发现,尽管不同模型的鲁棒性层级清晰,但轨迹指标并未同等贡献于这一识别。平均损失轨迹和梯度对齐模式在对抗训练模型中表现相似,即使它们的鲁棒精度差异显著。相比之下,失败步数分布能更清晰地区分鲁棒性级别,直接反映模型对对抗扰动的功能性抵抗。 这一结果表明,轨迹级诊断更多描述了优化几何特性,而非独立衡量鲁棒性。其可解释性依赖于鲁棒性级别、攻击强度和多种指标的综合评估。因此,轨迹级分析应作为补充诊断工具,结合上下文解读,而非替代标准鲁棒性测量。
AI 模型的效率评估近年来成为学术界和工业界关注的焦点,尤其是在模型规模急剧膨胀、能源消耗与日俱增的背景下。传统上,**浮点运算次数(FLOPs)** 被广泛用作衡量计算成本的指标,但 FLOPs 与真实执行时间之间的关系远比想象中复杂。近期,一篇发表于 arXiv 的论文(arXiv:2608.14550)通过复现实验,深入探讨了这一话题,并揭示了 FLOPs 作为效率指标的局限性。 ## 研究背景与动机 随着大语言模型等巨型模型的兴起,AI 训练和推理的能耗问题日益严峻。为了评估模型的效率,研究人员通常依赖 FLOPs 作为标准度量。然而,FLOPs 只反映了理论计算量,并未考虑硬件并行化能力、内存带宽等因素。例如,某些操作虽然 FLOPs 相同,但由于并行化难易程度不同,实际执行时间可能差异显著。 ## 复现实验与发现 该论文的作者 Enrique Barba Roque 和 Luís Cruz 旨在复现此前一项提出 **α-FLOPs 估算公式** 的研究,以验证其在新一代硬件上的适用性。在复现过程中,他们发现原始研究提供的复现材料存在诸多不足,例如缺乏具体的依赖项说明和回归数据的透明度。 实验结果显示,**原始研究的核心论点——FLOPs 不能直接代表执行时间——得到了验证**。具体而言,空间维度(如矩阵的宽高)相比卷积核维度更容易并行化,这导致相同 FLOPs 的操作在真实执行中耗时不同。然而,精细测量揭示了一个更复杂的图景:**新硬件在执行时间上表现出不稳定性和不连续性**,出现跳跃和振荡现象,而 α-FLOPs 公式通常低估了这些波动。 ## 结论与启示 尽管验证了原始研究的经验发现,但 α-FLOPs 估算在实际应用中的表现并不理想。这一负面结果凸显了硬件相关效率评估的复杂性,也再次强调了**完整、准确的复现包**对于研究可复制性的重要性。作者提供了完整的复现包,以促进后续研究。 这项研究为 AI 效率评估领域敲响了警钟:依赖单一指标(如 FLOPs)可能误导优化方向,未来的评估方法应更加注重实际工作负载和硬件特性的结合。对于开发者而言,这意味着在模型部署和优化时,不能仅看理论计算量,还需考虑目标硬件的实际性能特征。
AI 安全研究长期聚焦于技术对齐(确保 AI 输出符合人类意图)以及生成式 AI 的社会影响(如失业风险与劳动力市场冲击)。然而,一个同样关键的维度——对 AI 系统本身的依赖所蕴含的风险——却往往被忽视。近日,一篇由 Jaeho Kim 等人提交至 ICML 2026 Position Track 并获 Spotlight 的论文,提出了“AI Lock-In”(AI 锁定)这一概念,警示我们:**过度依赖 AI 正在导致人类技能退化、独立功能弱化,并埋下系统性隐患**,一旦 AI 服务中断或遭受攻击,后果可能不堪设想。 ## 什么是 AI Lock-In? 论文将 AI Lock-In 定义为一种现象:当人类对 AI 系统的依赖达到一定程度后,自身能力逐渐萎缩,独立运作能力下降,同时整个系统变得脆弱,一旦 AI 不可用或被破坏,便会引发连锁反应。这并非未来学式的猜想,而是**已经在个人、社会和国家层面显现的现实威胁**。 ## 从个体技能萎缩到国家基础设施瘫痪 论文通过详细的情景分析,展示了 AI Lock-In 如何在多个层面升级: - **个体层面**:过度依赖 AI 辅助工具(如写作、编程、决策支持)会导致相关技能退化。例如,长期依赖 AI 翻译的人,外语能力可能逐渐生疏;依赖 AI 导航的人,方向感可能弱化。 - **社会层面**:当 AI 系统成为基础设施的一部分(如医疗诊断、交通调度、金融交易),一旦出现故障,可能引发大范围混乱。 - **国家层面**:关键基础设施对 AI 的依赖,可能成为地缘政治冲突中的攻击目标。论文特别指出,AI 服务的中断或遭受网络攻击,可能被放大为国家级的系统性危机。 ## 为何 AI Lock-In 被忽视? 论文认为,当前 AI 安全研究主要关注“如何让 AI 更安全”,却较少思考“如何让人类在 AI 缺席时依然能正常运作”。这种忽视源于一种技术乐观主义,即默认 AI 系统总是可用且可靠的。然而,现实是 AI 系统可能因故障、网络攻击、供应链中断或政策限制而不可用。 ## 如何应对 AI Lock-In? 论文强调,**必须主动应对,而非等到依赖根深蒂固甚至不可逆转时才行动**。为此,他们提出了分层次的缓解建议: - **个人层面**:保持关键技能的训练,避免完全依赖 AI 工具。 - **组织层面**:建立 AI 系统的备份方案,确保关键业务在 AI 中断时仍能运行。 - **国家层面**:将 AI 依赖纳入国家安全评估,制定应急预案,并在关键基础设施中保留人工干预能力。 ## 结语 AI Lock-In 是一个系统性威胁,它与技术对齐、社会影响同等重要,却尚未得到充分关注。这篇论文的价值在于,它提醒我们:**在拥抱 AI 带来的便利时,必须警惕其潜在的“反噬”**。正如论文所主张的,保护个体自主性和国家安全,需要我们在依赖与独立之间找到平衡,提前布局,才能在未来可能的风暴中立于不败之地。
一项最新研究探索了大语言模型(LLM)在医学诊断中的元认知能力,即模型能否准确评估自身回答的可靠性。该研究由Ahmad Nazzal主导,论文预印本发表在arXiv上(编号2608.14552),提出了一种基于心理物理学原理的临床基准测试,专门评估模型在诊断选择与置信度判断上的表现。 ## 研究设计:模拟真实临床不确定性 研究者聚焦于两种常见且易混淆的老年认知障碍:**阿尔茨海默型神经认知障碍(AT-NCD)**与**抑郁相关认知损害(DRCI)**。他们生成了45个合成临床案例,系统变化证据强度、矛盾信息和缺失信息,每个案例以三种不同提示形式呈现,共进行135次试验。初步实验使用**gpt-4.1-nano**模型,所有试验均产生有效结构化输出。 ## 核心发现:置信度并非“盲目自信” 结果显示,模型在二选一诊断任务中的准确率达到**93.5%**,平均置信度为**78.4%**,AUROC²为**0.876**。更重要的是,置信度变化符合预期:当证据远离诊断边界时置信度上升,信息缺失时下降,且正确试验的置信度高于错误试验。这表明模型的置信度**部分反映了其回答的可靠性**,并非完全无意义。 ## 局限与风险:特定情况下的过度自信 然而,错误并非随机分布。在中等证据强度且存在矛盾的AT-NCD案例中,模型更倾向于误判为DRCI,并且在这些错误中表现出**过高的置信度**,与实际准确率不匹配。这提示了局部的校准失败,即模型在特定情境下可能“自信地犯错”。 ## 行业意义:超越准确率评估模型 该研究强调,评估医疗AI不应仅看准确率,还应直接测量其置信度质量。不同模型的能力差异可能无法从基准准确率中推断,因此**元认知评估**应成为标准测试的一部分。这一框架为未来医疗AI的可靠性和安全性评估提供了可复现的参考。 随着LLM在临床中的应用日益增多,理解其何时“知道”与“不知道”至关重要。该研究为这一方向迈出了重要一步,但仍需在更大规模、更多样化的临床场景中验证。
在多智能体强化学习(MARL)中,智能体之间的通信是协作的关键,但一个长期被忽视的问题是:**智能体应该何时通信**?现有方法要么在每个时间步都进行通信,要么通过REINFORCE策略梯度学习一个二值门控信号,后者往往因高方差而训练不稳定,且门控行为难以解释。 最近,一篇来自arXiv的论文提出了一种更 principled 的替代方案:**基于KL散度的信念门控机制**。每个智能体维护一个关于潜在世界状态的信念分布,该分布通过对LSTM隐藏状态进行softmax计算得到。智能体仅在信念分布之间的KL散度超过固定阈值时进行通信,从而避免无谓的信息交换,提高通信效率。 研究者在IC3Net的Predator-Prey基准和MPE simple_spread环境上进行了实验。在10x10的Predator-Prey任务中,IC3Net在所有阈值下都优于KL门控方法;但在更困难的20x20任务中,阈值消融实验呈现出倒U型关系:当阈值ε=0.5时,KL门控方法达到**73.84步平均完成时间和42%成功率**,而IC3Net为75.31步和31%,提升了1.47步和11个百分点,且种子方差更小。 更令人意外的是,在MPE环境中,即使门控机制未激活,引入信念头也带来了**平均奖励提升12点、方差降低26倍**的效果。这表明该方法的贡献有两个正交来源:一是当信念能够收敛时,门控机制提供了更合理的通信时机;二是信念头本身改善了潜在表示,从而促进了智能体间的协调。 这项研究为多智能体通信的“时机”问题提供了新的视角,提示我们**通信决策应基于信息论原则,而非简单的随机策略**。其潜在应用包括无人机编队、自动驾驶车队协同等需要高效通信的场景。不过,论文也指出,在简单任务中该方法并未超越现有基线,说明其优势主要体现在复杂环境中,未来工作可进一步探索如何动态调整阈值或结合其他门控机制。
近期,一项来自 arXiv 的新研究提出了一种名为 **前向传播仅 MLP 训练(Forward-Pass-Only MLP training, FPO)** 的方法,旨在在不通过模型主体进行反向传播的情况下适配大型语言模型(LLM)。该方法宣称能实现 **2.7 至 3.2 倍**的标准微调吞吐量,同时峰值训练内存减少约 **40%**,并在领域外基准测试中保持与基线相当的种子噪声水平,这一特性是完整网络微调所无法可靠复现的。 ## 核心观察:输出层误差近似真实梯度 FPO 方法建立在一个经验观察之上:在 Transformer 的后期层中,输出层的预测误差与真实梯度的余弦相似度在 0.47 至 0.59 之间(基于六个公开模型的调查)。这意味着,模型后期层的梯度可以通过输出层的误差信号来近似,而无需进行完整的反向传播。 为了利用这一特性,研究者引入了一个 **两分钟的诊断工具**,可以量化每一层的这种近似程度,从而确定哪些层适合进行后期层适配。基于该诊断,FPO 仅计算一次输出误差信号,并将其应用于每个目标层,不进行层间信号传播,也不构建任何自动微分图。 ## 实验评估:性能与效率的平衡 研究者在三个模型家族上评估了 FPO:**OLMo-2-7B、Qwen3-8B 和 Falcon3-7B**。实验结果显示,FPO 在领域内困惑度上均有改善,同时在 **MMLU、ARC-Challenge、HellaSwag 和 Winogrande** 等基准测试中保持与基线相当的种子噪声水平。此外,将标准监督微调(SFT)定位到 FPO 的目标层也能达到类似效果,但墙钟时间成本是 FPO 的 **2.2 倍**。 ## 意义与展望 这项研究为大模型的高效适配提供了新的思路。传统的全网络微调计算成本高昂,而 FPO 通过避免反向传播,显著降低了计算和内存开销,同时保持模型性能。这对于资源受限的场景尤为重要,例如在边缘设备上部署或快速迭代模型。 然而,该方法的适用性可能局限于后期层,对于需要深层特征调整的任务,其效果仍需进一步验证。此外,诊断工具的实用性也依赖于模型架构的多样性。未来,研究者可以探索将 FPO 与其他参数高效微调技术(如 LoRA)相结合,以进一步提升效率。 总体而言,FPO 展示了在保持模型性能的同时大幅提升训练效率的可能性,为大模型的应用开辟了新的路径。
智能手机存储空间,你真的需要那么多吗?制造商在销售手机时赚一笔,在云存储服务上又赚一笔。本文教你如何用美元而非GB来思考存储成本,避免浪费钱。 ## 存储空间:制造商的“二次盈利”陷阱 现代智能手机是完美的“增销”工具,制造商可以**双重获利**:一次是销售手机,另一次是后续的云存储服务。焊死的存储芯片加上大多数手机取消了microSD卡槽,使得消费者容易产生存储焦虑,从而诱导购买更高配置的版本或订阅云服务。 ## 用美元思考,而不是GB 存储空间的真正成本应该用**美元/GB**来衡量,而不是单纯看GB数。例如,一部手机从256GB升级到512GB可能需要多付100美元,但如果你实际用不到那么多空间,这笔钱就白花了。相反,如果你需要大量存储,购买云存储服务可能更划算。 ## GB的实际价值:比你想象的要小 很多人高估了自己对存储的需求。一张照片大约5MB,一首歌约10MB,一个App约100MB。**1GB可以存储约200张照片或100首歌曲**。除非你拍摄大量4K视频或安装超大型游戏,否则128GB通常足够日常使用。 ## 更好的存储管理策略 - **定期清理**:删除不常用的应用和重复的照片。 - **使用云存储的免费层**:如Google Photos(15GB免费)、iCloud(5GB免费)等,合理利用免费额度。 - **流媒体而非下载**:音乐和视频优先使用流媒体服务,减少本地存储占用。 - **购买前评估真实需求**:回顾过去一年的存储使用情况,再决定购买多大容量。 ## 总结:把钱花在刀刃上 不要被制造商的营销策略牵着走。**以美元为单位计算存储成本**,并理性评估自己的使用习惯,才能避免为不需要的存储空间买单。记住,存储空间是为你服务的,而不是让你焦虑的。
在快速变化的AI行业中,NVIDIA不仅以GPU硬件闻名,也在内部积极采用AI工具提升运营效率。近日,NVIDIA分享了其团队使用ChatGPT Work的实践案例,展示了这一企业级AI助手如何帮助知识工作者减少手动任务、连接快速变化的信号,并实现工作流程的规模化复制。 ## 从手动到自动:GTC筹备效率大幅提升 NVIDIA的GTM(Go-To-Market)团队负责全球销售、业务拓展和产品战略的执行与衡量。在筹备全球AI大会GTC期间,团队成员Will Daney曾深陷繁琐的数据整理工作:在电子表格中汇编客户名单、跟踪注册情况、帮助团队确定行动项。这些手动分析一度占据他约40%的工作时间。 如今,Will将大部分工作转化为ChatGPT Work自动化流程,每周运行两次。在12周的GTC筹备周期中,这一工作流每周节省约16小时。节省下来的时间被重新投入到与现场团队的协作中,更好地理解客户需求并制定成功策略。 ## 快速原型,缩短创新周期 除了运营效率,ChatGPT Work还加速了解决方案架构师的工作。过去,创建可用的原型通常需要2到3周,而现在借助ChatGPT Work,这一周期缩短至3到5天。这种速度的提升使NVIDIA团队能够更快地响应外部AI动态,并将其与内部优先级相连接。 ## 规模化复制工作流 ChatGPT Work的一大优势在于其可复制性。Will开发的流程不仅适用于GTC,还能被其他区域团队采用。支持圣何塞、台北、欧洲和华盛顿特区活动的同事都接收了他的ChatGPT工作流,并根据本地需求进行定制。这种自下而上的方式,让工作流能够跨团队、跨区域灵活扩展,无需等待新工具采购和实施。 ## 连接外部信号与内部行动 在AI领域,外部信息更新频繁。NVIDIA团队通过ChatGPT Work从每周25至40条外部AI更新中提取5至8条可行动信号,确保团队能够快速聚焦关键动态。这种信息筛选和行动导向的能力,使得知识工作者从信息收集者转变为决策执行者。 ## 总结 NVIDIA的实践表明,ChatGPT Work不仅是效率工具,更是组织知识复用的平台。通过简化手动流程、加速原型开发、支持工作流分享,ChatGPT Work正在帮助NVIDIA这样的技术巨头在竞争激烈的AI市场中保持敏捷。对于其他企业而言,这提供了一个清晰的示范:AI助手如何从个人效率工具演变为组织级能力放大器。
**Anthropic 的年化收入再次刷新纪录,突破 650 亿美元大关,增速之快令市场侧目。** 据彭博社周一报道,截至 7 月底,这家 AI 模型制造商的年化收入运行率已超过 650 亿美元,较 5 月的 470 亿美元大幅增长,而去年年底这一数字仅为 90 亿美元。年化收入运行率是一种基于近期较短时期数据推算全年收入的指标,其大幅跃升凸显了 Anthropic 商业化的迅猛势头。 尽管 Anthropic 尚未对置评请求作出回应,但据英国《金融时报》报道,其投资方预计公司今年剩余时间将保持相近增速,全年收入有望达到 **1000 亿至 1200 亿美元**。与此同时,竞争对手 OpenAI 的收入也实现翻倍,从 2025 年底的 200 亿美元增至 400 亿美元(彭博社上周报道)。虽然两家公司在收入计算方式上可能存在差异,但 Anthropic 的增长速度显然更令投资者着迷。 ## 上市在即,估值或创纪录 两家公司均已秘密提交 IPO 文件,而 Anthropic 预计将先于 OpenAI 登陆公开市场,最早可能在今年秋季。据《金融时报》报道,Anthropic 寻求的公开估值将达 **2 万亿美元或更高**,这将是史上规模最大的上市交易。此前,Anthropic 在 5 月底完成一轮 650 亿美元的融资时,估值已达 9650 亿美元。 ## 行业影响与展望 Anthropic 的爆发式增长不仅反映了 AI 市场的巨大需求,也预示着行业竞争格局的深刻变化。其高估值和高增长可能吸引更多资本涌入 AI 赛道,同时也给竞争对手带来压力。对于投资者而言,Anthropic 的 IPO 将是一个关键观察窗口,其市场表现或将定义 AI 时代的估值基准。 随着 AI 商业化进程加速,Anthropic 能否维持这一增速、OpenAI 又将如何应对,都是未来数月值得关注的焦点。
**AI 自动化初创公司 Relay 宣布关闭,其创始人兼 CEO Jacob Bank 将重返谷歌,担任 Chrome 浏览器产品副总裁,部分员工也将加入 Chrome 团队。** Relay 成立于 2021 年,曾被视为“新 Zapier”,旨在通过 AI 驱动的自动化工具帮助企业简化重复性工作,如文档起草、校对和项目管理。然而,该公司于 7 月首次宣布关闭,免费用户已于 8 月 15 日失去访问权限,付费用户的服务将在 9 月 14 日终止。 Jacob Bank 在 X 上表示:“我整个职业生涯都在做一件事:构建帮助人们利用 AI 提高效率的工具,同时不牺牲个人创造力和洞察力。加入 Chrome 团队是将这些经验带给更多人的理想机会。”他还透露,团队在 Chrome 中集成 AI 有“雄心勃勃的计划”,未来将分享更多细节。 Bank 的职业生涯始于谷歌,2015 年其创立的日程应用 Timeful 被谷歌收购后,他加入谷歌,曾负责 Gmail、Google Calendar 和 Google Chat 的产品工作。离开谷歌后,他创立了 Relay。如今,他重返谷歌,将领导 Chrome 的产品和开发者关系团队。 这一动向是谷歌持续将 AI 融入用户体验的又一例证。此前,谷歌已将 Gemini 集成到搜索和 Chrome 浏览器中,作为可选的浏览器内助手。近期谷歌报告称,Gemini 用户已突破 10 亿,显示出用户对 AI 集成的积极反馈。 **尽管 Relay 的关闭令人遗憾,但其团队加入谷歌,特别是 Chrome 部门,预示着 AI 与浏览器深度融合的未来。** 正如 Bank 所言,Chrome 是“与代理协作的理想场所”。此举可能会加速 AI 在日常工作流中的普及,为用户带来更智能的浏览和任务处理体验。 对于 Relay 的现有用户,建议尽快迁移数据并寻找替代方案。而行业观察者则关注谷歌如何将 AI 代理嵌入 Chrome,这或将成为浏览器竞争的新焦点。
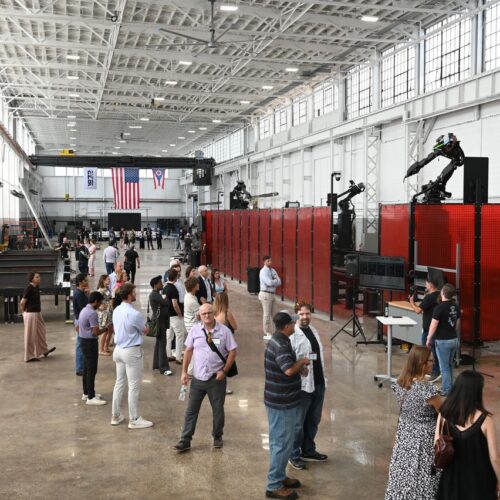
一家由前SpaceX工程师创立的初创公司,正在开发一种全新的机器人工厂,旨在自动化生产钢铁部件。该公司的核心理念并非追求全自动化,而是强调人机协作与灵活制造,这一思路在制造业中引发了广泛关注。 ## 从航天到制造:技术迁移的必然 这些工程师曾参与SpaceX的火箭制造项目,深知传统制造业的痛点:工序复杂、人工依赖度高、效率瓶颈明显。他们将航天领域积累的精密制造与自动化经验,引入到通用钢铁部件的生产中,试图打造一个能够快速适应不同订单的柔性制造系统。 ## 核心设计:不追求“无人化” 与许多追求“黑灯工厂”的企业不同,这家公司明确表示:“我们并非教条地追求全自动化。”其机器人系统更注重与人类工人的协同——机器人负责高强度、重复性的工作,而人类则专注于需要判断力和灵活性的环节。这种务实的设计理念,既降低了技术落地难度,也保留了应对复杂工况的弹性。 ## 行业影响与挑战 钢铁部件制造业长期面临劳动力短缺和成本压力,自动化升级已成为行业共识。然而,传统工业机器人的编程复杂、部署周期长,难以适应中小批量订单。该团队的方案若成功,可能为行业提供一种新的范式。不过,目前项目仍处于早期阶段,具体的技术细节和商业化时间表尚未公开。 ## 小结 前SpaceX工程师的跨界创业,反映了高端制造技术向通用工业领域渗透的趋势。其“人机协作”的务实路线,或许正是自动化落地的最优解之一。未来,这一模式能否大规模复制,值得持续关注。
近日,OpenAI 宣布将其最新模型 GPT-5.6 Sol 的定价下调 50%,这一消息迅速在 Hacker News 上引发热议,获得 213 分和 122 条评论。对于 AI 开发者和企业用户而言,这无疑是一个重大利好,标志着高性能 AI 模型的使用门槛进一步降低。 ## 降价背后的行业趋势 GPT-5.6 Sol 作为 OpenAI 的旗舰模型,在推理能力和多任务处理上表现卓越,但其高昂的调用成本一直让许多中小型团队望而却步。此次降价 50%,意味着开发者可以以更低的成本将 GPT-5.6 Sol 集成到产品中,无论是用于自然语言处理、代码生成,还是复杂的逻辑推理,都将更具性价比。 从行业角度看,这一举措反映了 AI 算力成本的整体下行趋势。随着模型优化和硬件效率的提升,头部厂商正通过价格战来争夺市场份额,同时也为了推动 AI 技术的更广泛应用。对于用户来说,这意味着更多的选择和更低的试错成本。 ## 对开发者与企业的实际影响 对于初创公司和独立开发者,降价直接降低了产品的运营成本,使得基于 GPT-5.6 Sol 的创新应用成为可能。例如,一个依赖大量 API 调用的聊天机器人,其月度费用可能因此减少一半,从而让创业者能将更多资金投入到产品迭代和市场营销中。 对于大型企业,降价同样具有战略意义。在部署大规模 AI 解决方案时,成本往往是关键考量因素。此次降价可能促使更多企业将 GPT-5.6 Sol 纳入其技术栈,加速业务流程的智能化转型。 ## 社区反响与未来展望 Hacker News 上的讨论热烈,不少开发者对此表示欢迎,同时也在探讨降价是否会影响模型质量或引发更激烈的竞争。部分评论指出,OpenAI 此举可能是为了应对来自 Anthropic、Google 等竞争对手的压力,通过价格优势巩固市场地位。 无论如何,GPT-5.6 Sol 的降价都为 AI 行业注入了新的活力。未来,随着技术不断成熟,我们有理由期待更多高性能模型以更亲民的价格出现,从而推动整个生态的繁荣。对于开发者而言,现在正是探索 GPT-5.6 Sol 潜力的好时机。
美国警用科技巨头 Flock 上周宣布对其平台进行更新,旨在防止警员出于非法或不正当目的(如跟踪骚扰)使用其系统。此前《华盛顿邮报》曝光了 50 起警员滥用 Flock 及其竞争对手系统的案件,其中不乏跟踪骚扰女性的案例。例如,威斯康星州一名女性声称其前男友警员曾搜索她的车辆 179 次;另一名女性则遭到警察局长的跟踪,却无处举报。 Flock 的回应措施包括:要求警员在搜索前输入案件编号,并使用软件标记异常搜索行为。然而,这些新规存在明显漏洞——警员可以输入虚假的案件编号,就像他们过去绕过 Flock 其他安全措施一样。更重要的是,这些政策并未触及公民自由和隐私团体更广泛的担忧:Flock 正将原本作为打击犯罪工具的产品,演变成一个大规模监控网络。 这种批评已引发越来越多的抵制,一些城市取消了合同,一些州试图立法限制或完全禁止车牌读取器。在此背景下,出现了不少为 Flock 辩护的声音:如果这些摄像头有助于破案,又有什么大不了的呢?在运气好的时候,它们或许能帮助抓获绑匪;即便不能,它们也只是拍下我的汽车照片,没人会费心去看。 暂且不论 Flock 系统在多大程度上真正解决或预防了犯罪这一未解问题,上述辩护忽略了一个更重要的问题:Flock 选择构建的是什么样的犯罪打击系统?其网络之所以如此运作,是因为一系列关于收集什么信息、谁可以搜索、保存多久以及共享范围有多广的决策。这些决策设定了安全与公民自由之间交易的条款。相信技术应在打击犯罪中发挥作用,并不意味着要盲目接受这些条款。 例如,Flock 新要求警员在运行搜索前输入案件编号,但这不过是一个形式上的门槛。真正需要审视的是,Flock 的商业模式依赖于大规模数据收集和广泛共享,这必然带来隐私侵蚀的风险。在技术便利与公民权利之间,我们需要更审慎的平衡,而不是简单地为效率辩护。
根据Salesforce最新发布的《2026年Agentic Enterprise Index》报告,企业级AI代理的采用率在过去一年中激增。报告显示,平均每家企业活跃的AI代理数量从5个增至13个,几乎翻了三倍,而创建时间缩短了53%,平均只需1.9天即可创建一个代理。同时,AI代理的能力提升了350%,能够处理更复杂的任务。员工每周发起的代理会话数量自2025年2月以来也增长了三倍,表明信任度显著提升。 报告基于对400家实际使用AI代理驱动ROI的企业连续五个季度的数据,以及对九个关键市场近5000名受访者的调查。数据显示,消费者导向型行业(如零售和旅游)在部署速度和整体使用上领先,尤其在假日等高峰需求季节。而受监管行业(如金融、医疗)采用速度较慢,但所使用的代理往往更为复杂。Salesforce将代理完成的工作单元称为“Agentic Work Units”(AWUs),受监管行业的AWU占比虽低,但每个代理的智能化程度更高。 企业AI代理已从实验性测试转向快速、生产级部署。这一趋势表明,AI代理正在从概念验证走向实际业务价值。Salesforce的报告强调,不同行业正在找到最适合自身业务需求的策略,而可衡量的ROI是推动进一步采用的关键。
近期,一则关于亚马逊的新闻在科技圈引起轩然大波:通过隐藏在书籍中的AirTag追踪,发现亚马逊正将大量珍稀书籍销毁,用于训练人工智能模型。这一行为不仅引发了环保和文化遗产保护者的强烈抗议,也让人们开始审视AI发展背后的资源消耗问题。 ## 事件背景 据爆料,亚马逊的一个团队以霸王龙准备吞噬书籍作为标志,这一极具象征意义的图标似乎暗示了其行为本质。通过AirTag的定位信息,追踪者发现这些书籍并非被妥善保管或转售,而是被直接送入碎纸机或焚烧炉。这些书籍中不乏具有历史、艺术或学术价值的稀有版本,它们的消失意味着不可逆的文化损失。 ## AI训练的资源代价 训练大型语言模型需要海量文本数据,而书籍作为高质量文本的重要来源,自然成为科技公司的目标。然而,亚马逊此次的做法却引发了广泛质疑:为何要销毁而非数字化?有分析指出,这可能与版权问题有关——将实体书销毁可以避免版权纠纷,同时又能“合理”使用其内容。但这种做法显然忽视了书籍作为文化遗产的珍贵性。 ## 行业影响与反思 这一事件折射出AI产业在数据获取上的“灰色地带”。此前,谷歌、Meta等公司也曾因未经授权使用受版权保护的书籍训练模型而遭到诉讼。亚马逊的行为若属实,将可能面临法律和道德的双重压力。环保组织指出,大规模销毁书籍不仅浪费资源,还加剧了森林砍伐和碳排放。而文化遗产保护者则呼吁,科技公司应寻求更可持续、更尊重知识产权的数据获取方式。 ## 未来展望 目前,亚马逊尚未对此事做出官方回应。但这一事件无疑为AI行业敲响了警钟:技术进步不应以牺牲文化传承和环境为代价。未来,如何在数据需求与伦理责任之间取得平衡,将是所有AI从业者必须面对的课题。或许,建立更透明的数据来源机制、加强版权合作,以及探索合成数据等替代方案,将成为行业发展的新方向。
NVIDIA Nemotron 3.5 Lightning 现已上线 Amazon SageMaker JumpStart,这是一款专为高并发 Agent 工作负载设计的开源模型。该模型采用混合专家(MoE)架构,总参数量 30B,但仅有 3B 激活,可在单 GPU 上运行,吞吐量最高提升 4 倍,任务完成速度最高提升 30%。本文介绍如何通过 SageMaker JumpStart 快速部署该模型,并解析其技术亮点与适用场景。
Linux 内核 7.2 正式发布,带来缓存感知调度、文件系统与 I/O 改进,以及对 AMD、Intel、Apple、Nvidia、USB4 和笔记本电脑硬件的大量新支持。 ## 发布背景 Linus Torvalds 在上周末宣布了 Linux 内核 7.2 的发布。他在发布说明中写道:“本周的发布——再次——比我希望的要大,但嘿,既然‘新常态’就是这样,如果因为这个原因推迟发布,我们可能永远不会发布。” ## AI 与 Linux 开发 Torvalds 在 7.2 的第七个候选版本说明中解释了“新常态”:大量修复,其中许多是由各种 AI 工具审查发现的。这些变更并非 AI 编写的新功能,而是针对 AI 发现的安全漏洞的补丁,但累积起来影响不小。 在 7.1 内核发布前,Torvalds 曾表示,AI 报告的持续涌入使安全列表几乎无法管理,因为不同的人用相同工具发现相同问题,造成大量重复。他主张 AI 检测到的 bug 本身就不是秘密,将其放在私人列表上是对所有人时间的浪费,只会加剧重复。 不过,Torvalds 并不反对使用 AI。他曾强调:“AI 工具很好,但前提是它们确实有帮助,而不是造成不必要的痛苦和无意义的假工作。欢迎使用它们,但……” ## 关键改进 ### 缓存感知调度 Linux 7.2 引入了缓存感知调度,通过优化处理器缓存的使用来提升处理速度。这对于现代多核处理器尤其重要,可减少缓存未命中,提高整体性能。 ### 文件系统与 I/O 改进 本次更新还带来了文件系统和 I/O 方面的多项改进,有望增强存储性能与稳定性。 ### 硬件支持扩展 新内核大幅扩展了对 AMD、Intel、Apple、Nvidia、USB4 以及笔记本电脑硬件的支持,覆盖了更广泛的设备与平台。 ## 总结 Linux 7.2 在 AI 辅助下变得更加健壮,缓存感知调度等新特性将推动性能提升,而广泛的硬件支持则让新内核能够更好地适应多样化的计算环境。
随着 AI 数据中心对内存和存储的需求激增,树莓派等单板计算机的价格水涨船高。如果你手头正好有一部闲置的旧安卓手机,不妨考虑将其改造为树莓派的替代品,用于个人项目开发。不过,在动手之前,你需要了解其中的利弊和潜在风险。 ## 价格飙升,树莓派不再亲民 近年来,AI 技术的爆发式增长导致 RAM 和存储芯片价格持续上涨,树莓派也未能幸免。原本几十美元的开发板,如今价格翻倍甚至更高,让不少爱好者望而却步。在这种情况下,利用旧手机作为替代方案,成为了一种经济实惠的选择。 ## 旧手机的优势与不足 旧安卓手机作为计算平台,拥有不少天然优势: - **性能不俗**:即使是几年前的旗舰机型,其处理器性能也远超入门级树莓派。 - **自带屏幕和电池**:无需额外购买显示器、电源等配件,便携性极佳。 - **传感器丰富**:内置摄像头、GPS、加速度计等传感器,可扩展更多应用场景。 - **通信功能**:支持 Wi-Fi、蓝牙,甚至蜂窝网络,便于物联网项目。 然而,也存在一些挑战: - **软件生态不同**:树莓派运行的是 Linux 桌面系统,而安卓系统面向移动设备,部分开发工具链需要适配。 - **IO 接口有限**:树莓派提供 GPIO 引脚,方便连接外部硬件,而旧手机缺乏这类接口,需要借助 USB OTG 或蓝牙等方式扩展。 - **电池老化**:旧手机电池可能已经老化,长期高负载运行存在安全隐患,建议移除电池并直接供电。 ## 安全改造,避免变砖 直接刷入 Linux 系统到手机有风险,操作不当可能导致设备变砖。文章推荐一种更安全的方法:**使用 Termux 等终端模拟器**,在安卓系统内运行 Linux 环境,无需刷机即可享受类 Linux 体验。这样既能利用手机硬件,又能降低风险。 当然,如果你对技术有足够信心,也可以尝试安装 LineageOS 等第三方 ROM,进一步优化系统性能。但务必提前备份数据,并遵循社区教程。 ## 结语 将旧安卓手机改造为树莓派替代品,不仅环保省钱,还能为你的项目增添新玩法。但在动手前,请权衡利弊,选择适合自己的方案。如果你有相关经验,欢迎分享你的改造故事。
在最近的 Made by Google 活动上,谷歌传递了一个耐人寻味的信号:它希望你减少对手机的使用,转而更多地依赖 AI。这一主题贯穿了整场发布会,从 Pixel 11 Pro 的推广到多位明星的站台,都在强调“活在当下”的理念。然而,这种叙事背后隐藏着更深层的商业逻辑——谷歌正试图用 AI 来重塑我们与科技的关系,而这段关系恰恰是它自己一手塑造的。 ## 矛盾的营销策略 谷歌在活动中宣称,其新手机将帮助用户“更专注当下”,减少屏幕时间。但讽刺的是,这些手机内置了更强大的 AI 助手,能够更主动地介入用户的生活。例如,Pixel 11 Pro 的 AI 功能可以自动整理通知、代写消息,甚至预测用户需求。谷歌似乎在暗示:你不需要频繁操作手机,因为 AI 会替你完成一切。 这种策略并非首次出现。苹果在 iOS 17 中引入了“屏幕距离”提醒,三星也推出了“数字健康”工具。但谷歌的表述更为激进——它不只是减少使用时间,而是试图改变用户与设备的互动方式。 ## 谁在买单? 问题在于,消费者会接受这种叙事吗?一方面,许多用户确实对“数字排毒”感兴趣,他们愿意为减少干扰的功能付费。另一方面,谷歌的 AI 功能往往需要更多的数据收集,这与用户对隐私的担忧相冲突。此外,AI 的自主性也可能引发信任问题——用户是否愿意让 AI 代为处理敏感信息? 从市场反应来看,谷歌的 Pixel 系列一直未能占据显著份额,而 AI 功能能否成为差异化卖点仍存疑。相比之下,苹果的隐私保护策略似乎更能赢得用户信任。 ## 结语 谷歌的“少用手机”宣传更像是一种营销话术,其核心目的是推广 AI 服务。这种策略能否奏效,取决于用户是否愿意接受 AI 作为“代理”来管理数字生活。但至少目前,大多数人可能仍会保持警惕。
手头有闲置的旧安卓手机或平板?别急着扔,它们完全可以变身为实验和开发用的测试服务器,过程比想象中简单。本文分享我的亲身实践,并探讨其背后的价值。 ## 为什么要把旧手机变成服务器? 旧手机性能虽不及现代PC,但作为低功耗、零噪音的测试服务器,性价比极高。它适合运行轻量级应用,如个人博客、API测试、内网穿透实验等,既环保又省钱。 ## 具体怎么做? 核心思路是安装Linux环境。我选择了 **Termux**,一款无需root即可在安卓上运行Linux终端的应用。步骤如下: 1. 安装Termux,并更新软件包。 2. 安装必要的软件,如Python、Node.js或nginx。 3. 编写并运行你的服务器脚本,或配置静态文件服务。 4. 确保手机与局域网在同一网络,通过分配的IP访问服务。 例如,用Python启动一个简易HTTP服务: ```bash python -m http.server 8080 ``` 然后在电脑浏览器输入`http://手机IP:8080`即可访问。 ## 注意事项 - **电池管理**:长时间供电可能让电池鼓包,建议拆下电池直接接电源(需一定动手能力),或使用充电控制应用。 - **网络稳定性**:Wi-Fi连接可能不稳定,若需长期运行,考虑使用USB网络共享或以太网转接。 - **安全性**:仅限局域网测试,若暴露公网,需配置防火墙和SSH密钥。 ## 小结 旧手机变服务器,既是环保之举,也是技术乐趣。它降低了实验门槛,尤其适合学习网络编程或快速原型验证。如果你有闲置设备,不妨一试。